

ZooKeeper アンサンブルは、1 つ以上の ZooKeeper ノードが失われても、データ損失なしで機能し続けるように設計されています。この復元力は、システムのダウンタイムなしで ZooKeeper ノードのメンテナンスを実行するために効果的に使用できます。
ZooKeeper と Edge について
Edge では、ZooKeeper ノードにさまざまな Edge コンポーネントの場所と構成に関する構成データが含まれており、構成の変更がさまざまなコンポーネントに通知されます。本番環境システムでサポートされているすべての Edge トポロジは、少なくとも 3 つの ZooKeeper ノードを使用します。
Edge 構成ファイルの ZK_HOSTS プロパティと ZK_CLIENT_HOSTS プロパティを使用して、ZooKeeper ノードを指定します。次に例を示します。
ZK_HOSTS="$IP1 $IP2 $IP3"
ZK_CLIENT_HOSTS="$IP1 $IP2 $IP3"
ここで
ZK_HOSTSには、ZooKeeper ノードの IP アドレスを指定します。IP アドレスは、すべての ZooKeeper ノードで同じ順序でリストする必要があります。マルチデータセンター環境では、すべてのデータセンターのすべての ZooKeeper ノードを一覧表示します。
ZK_CLIENT_HOSTSには、このデータセンターでのみ使用される ZooKeeper ノードの IP アドレスを指定します。IP アドレスは、データセンター内のすべての ZooKeeper ノードで同じ順序でリストする必要があります。単一のデータセンターのインストールでは、これらは ZK_HOSTS で指定されたノードと同じです。マルチデータ センター環境では、各データセンターの Edge 構成ファイルに、そのデータセンターの ZooKeeper ノードのみを記述する必要があります。
デフォルトでは、すべての ZooKeeper ノードがボーターノードとして指定されます。つまり、すべてのノードが ZooKeeper リーダーの選出に参加します。:observer 修飾子を ZK_HOSTS とともに含めると、ノードが投票者ではなくオブザーバー ノードであることを示すことができます。オブザーバー ノードはリーダーの選出に参加しません。
:observer 修飾子は通常、複数の Edge データセンターを作成する場合や、1 つのデータセンターに多数の ZooKeeper ノードがある場合に指定します。たとえば、2 つのデータセンターがある 12 ホストの Edge インストールでは、データセンター 2 のノード 9 の ZooKeeper がオブザーバーになります。
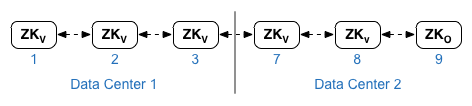
次に、データセンター 1 の構成ファイルで次の設定を使用します。
ZK_HOSTS="$IP1 $IP2 $IP3 $IP7 $IP8 $IP9:observer"
ZK_CLIENT_HOSTS="$IP1 $IP2 $IP3"
データセンター 2 の場合:
ZK_HOSTS="$IP1 $IP2 $IP3 $IP7 $IP8 $IP9:observer"
ZK_CLIENT_HOSTS="$IP7 $IP8 $IP9"
以降のセクションでは、リーダーノード、ボーターノード、オブザーバー ノードについて詳しく説明し、ボーターノードとオブザーバー ノードを追加する際の考慮事項について説明します。
リーダー、フォロワー、ボーター、オブザーバについて
マルチノード ZooKeeper インストールでは、ノードの 1 つがリーダーとして指定されます。他のすべての ZooKeeper ノードは、フォロワーとして指定されます。読み取りは任意の ZooKeeper ノードから行われますが、すべての書き込みリクエストはリーダーに転送されます。たとえば、新しい Message Processor が Edge に追加された場合、この情報は ZooKeeper リーダーに書き込まれます。すべてのフォロワーがデータを複製します。
Edge のインストール時に、各 ZooKeeper ノードをボーターまたはオブザーバーとして指定します。リーダーは、すべてのボーター ZooKeeper ノードによって選出されます。リーダーの選出に必要な条件は、機能している ZooKeeper ボーターノードの定足数が確保されていることです。クォーラムとは、すべてのデータセンターのすべてのボーター ZooKeeper ノードの半数以上が機能していることを意味します。
利用可能な投票ノードの定足数が満たされていない場合、リーダーは選出されません。このシナリオでは、ZooKeeper はリクエストを処理できません。つまり、再びクォーラムに達するまで、Edge Management Server に対してリクエストを行うことも、API リクエストを処理することも、新しい Edge UI にログインすることもできません。
たとえば、単一のデータセンターのインストールでは、次のようになります。
- 3 つの ZooKeeper ノードをインストールした
- すべての ZooKeeper ノードが投票者
- クォーラムは 2 つの機能する投票者ノードです
- ボーターノードが 1 つしかない場合、ZooKeeper アンサンブルは機能しません
2 つのデータセンターがあるインストールの場合:
- データセンターごとに 3 つの ZooKeeper ノードをインストールした(合計 6 ノード)。
- データセンター 1 には 3 つの投票者ノードがある
- データセンター 2 には 2 つのボーターノードと 1 つのオブザーバー ノードがある
- クォーラムは、両方のデータセンターにまたがる 5 つの投票者に基づいているため、3 つの機能する投票者ノードです。
- 使用可能なボーターノードが 2 つ以下の場合、ZooKeeper アンサンブルは機能しません。
ボーターノードまたはオブザーバ ノードの追加に関する考慮事項
システム要件によっては、Edge のインストールに追加の ZooKeeper ノードを追加する必要があります。ZooKeeper ノードの追加のドキュメントでは、Edge に ZooKeeper ノードを追加する方法について説明しています。ZooKeeper ノードを追加する場合は、追加するノードのタイプ(ボーターまたはオブザーバ)を考慮する必要があります。
1 つ以上のボーターノードがダウンしても ZooKeeper アンサンブルが機能するように、十分な数のボーターノードを確保する必要があります。つまり、ボーターノードのクォーラムがまだ利用可能であることを意味します。投票ノードを追加すると、クォーラムのサイズが増加するため、ダウンしている投票ノードの数を増やすことができます。
ただし、書き込みオペレーションではクォーラムがリーダーに同意する必要があるため、投票ノードを追加すると書き込みパフォーマンスに悪影響が及ぶ可能性があります。リーダーの決定にかかる時間は、ボーターノードの数に基づきます。ボーターノードを追加すると、この時間は長くなります。したがって、すべてのノードを投票者にするのは望ましくありません。
ボーターノードを追加する代わりに、オブザーバー ノードを追加できます。オブザーバー ノードを追加すると、リーダーの選出のオーバーヘッドを増やすことなく、システム全体の読み取りパフォーマンスが向上します。これは、オブザーバー ノードが投票に参加せず、クォーラム サイズに影響しないためです。したがって、オブザーバー ノードがダウンしても、アンサンブルがリーダーを選出する機能には影響しません。ただし、オブザーバー ノードが失われると、データ リクエストを処理できるノードが少なくなるため、ZooKeeper アンサンブルの読み取りパフォーマンスが低下する可能性があります。
単一のデータセンターでは、オブザーバー ノードの数に関係なく、投票者を 5 つ以下にすることをおすすめします。2 つのデータセンターでは、投票者を 9 人以下(1 つのデータセンターに 5 人、もう 1 つのデータセンターに 4 人)にすることをおすすめします。その後、システム要件に必要な数のオブザーバー ノードを追加できます。
ZooKeeper ノードを削除する
ZooKeeper ノードを削除する理由は、ノードが破損した、間違った環境に追加されたなど、さまざまです。
このセクションでは、ノードがダウンしてアクセスできない場合に Zookeeper ノードを削除する方法について説明します。
ZooKeeper ノードを削除するには:
- サイレント構成ファイルを編集し、削除する Zookeeper ノードの IP アドレスを削除します。
- Zookeeper の
setupコマンドを再実行して、残りの ZooKeeper ノードを再構成します。/opt/apigee/apigee-service/bin/apigee-service apigee-zookeeper setup -f updated_config_file
- すべての ZooKeeper ノードを再起動します。
/opt/apigee/apigee-service/bin/apigee-service apigee-zookeeper restart
- Management Server ノードを再構成します。
/opt/apigee/apigee-service/bin/apigee-service edge-management-server setup -f updated_config_file
/opt/apigee/apigee-service/bin/apigee-service edge-management-server restart - すべての Router を再構成します。
/opt/apigee/apigee-service/bin/apigee-service edge-router setup -f updated_config_file
/opt/apigee/apigee-service/bin/apigee-service edge-router restart - すべての Message Processor を再構成します。
/opt/apigee/apigee-service/bin/apigee-service edge-message-processor setup -f updated_config_file
/opt/apigee/apigee-service/bin/apigee-service edge-message-processor restart - すべての Qpid ノードを再構成します。
/opt/apigee/apigee-service/bin/apigee-service edge-qpid-server setup -f updated_config_file
/opt/apigee/apigee-service/bin/apigee-service edge-qpid-server restart - すべての Postgres ノードを再構成します。
/opt/apigee/apigee-service/bin/apigee-service edge-postgres-server setup -f updated_config_file
/opt/apigee/apigee-service/bin/apigee-service edge-postgres-server restart
メンテナンスに関する考慮事項
一度に 1 つのノードで実行した場合、完全に機能するアンサンブルでダウンタイムなしで ZooKeeper のメンテナンスを実行できます。一度に 1 つの ZooKeeper ノードのみがダウンするようにすることで、リーダーを選出するために利用可能なボーターノードのクォーラムが常に存在するようにできます。
複数のデータセンターでのメンテナンス
複数のデータセンターを使用する場合、ZooKeeper アンサンブルはデータセンターを区別しません。ZooKeeper アセンブリは、すべてのデータセンターのすべての ZooKeeper ノードを 1 つのアンサンブルとして表示します。
ZooKeeper がクォーラム計算を行う場合、特定のデータセンター内のボーターノードの場所は考慮されません。個々のノードがデータセンター間でダウンする可能性がありますが、アンサンブル全体でクォーラムが維持されている限り、ZooKeeper は機能し続けます。
メンテナンスに伴う影響
さまざまなタイミングで、ボーターノードまたはオブザーバ ノードのいずれかの ZooKeeper ノードをメンテナンスのために停止する必要があります。たとえば、ノード上の Edge のバージョンをアップグレードする必要がある場合、ZooKeeper をホストしているマシンが失敗する場合、ネットワーク エラーなどの理由でノードが使用できなくなる場合があります。
ダウンしたノードがオブザーバー ノードの場合、ノードが復元されるまで、ZooKeeper アンサンブルのパフォーマンスが若干低下します。ノードがボーターノードの場合、リーダー選出プロセスに参加するノードが失われるため、ZooKeeper アンサンブルの存続可能性に影響する可能性があります。投票者ノードがダウンした理由に関係なく、利用可能な投票者ノードのクォーラムを維持することが重要です。
メンテナンス手順
ZooKeeper アンサンブルが機能していることを確認してから、メンテナンス手順を実行します。これは、オブザーバー ノードが機能しており、メンテナンス中にクォーラムを維持するのに十分な投票者ノードが利用可能であることを前提としています。
これらの条件が満たされると、任意のサイズの ZooKeeper アンサンブルは、データの損失やパフォーマンスへの重大な影響なしに、任意の時点で単一ノードの損失を許容できます。つまり、一度に 1 つのノードであれば、アンサンブル内の任意のノードでメンテナンスを自由に実行できます。
メンテナンスの一環として、次の手順で ZooKeeper ノードのタイプ(リーダー、投票者、オブザーバー)を特定します。
- ZooKeeper ノードにインストールされていない場合は、
ncをインストールします。sudo yum install nc
- ノードで次の
ncコマンドを実行します。ここで、2181 は ZooKeeper ポートです。echo stat | nc localhost 2181
次のような出力が表示されます。
Zookeeper version: 3.4.5-1392090,
built on 09/30/2012 17:52 GMT
Clients: /a.b.c.d:xxxx[0](queued=0,recved=1,sent=0)
Latency min/avg/max: 0/0/0
Received: 1
Sent: 0
Connections: 1
Outstanding: 0
Zxid: 0xc00000044
Mode: follower
Node count: 653
ノードの出力の
Mode行には、ノード構成に応じてobserver、leader、またはfollower(リーダーではない投票者を意味します)が表示されます。 - 各 ZooKeeper ノードで手順 1 と 2 を繰り返します。
概要
ZooKeeper アンサンブルのメンテナンスを行う最適な方法は、1 つずつノードをメンテナンスすることです。注意事項:
- ZooKeeper アンサンブルが機能し続けるように、メンテナンス中にボーターノードのクォーラムを維持する必要があります。
- オブザーバー ノードを停止しても、クォーラムやリーダーを選出する機能には影響しません。
- クォーラムは、すべてのデータセンターのすべての ZooKeeper ノードで計算されます。
- 前のサーバーが稼働したら、次のサーバーのメンテナンスに進みます。
ncコマンドを使用して、ZooKeeper ノードを検査します。