

Edge for Private Cloud v4.18.01
In einer Produktionsumgebung ist es in der Regel erforderlich, Monitoring-Mechanismen in einer Apigee Edge for Private Cloud-Bereitstellung zu aktivieren. Diese Monitoring-Techniken warnen die Netzwerkadministratoren (oder Operatoren) vor einem Fehler oder Ausfall. Jeder generierte Fehler wird in Apigee Edge als Benachrichtigung gemeldet. Weitere Informationen zu Benachrichtigungen finden Sie unter Best Practices für das Monitoring.
Der Einfachheit halber werden Apigee-Komponenten hauptsächlich in zwei Kategorien unterteilt:
- Apigee-spezifische Java-Serverdienste: Dazu gehören Management Server, Message Processor, Qpid Server und Postgres Server.
- Drittanbieterdienste: Dazu gehören Nginx Router, Apache Cassandra, Apache ZooKeeper, OpenLDAP, PostgreSQL-Datenbank und Qpid.
In einer lokalen Bereitstellung von Apigee Edge bietet die folgende Tabelle einen schnellen Überblick über die Parameter, die Sie überwachen können:
|
Komponente |
Systemprüfungen |
Statistiken auf Prozessebene |
API-Level-Prüfungen |
Prüfungen des Nachrichtenflusses |
Komponentenspezifisch |
|
|---|---|---|---|---|---|---|
|
Apigee-spezifische Java-Dienste |
Verwaltungsserver |
? |
? |
? |
||
|
Message Processor |
? |
? |
? |
? |
||
|
Qpid-Server |
? |
? |
? |
|||
|
Postgres-Server |
? |
? |
? |
|||
|
Drittanbieterdienste |
Apache Cassandra |
? |
? |
|||
|
Apache ZooKeeper |
? |
? |
||||
|
OpenLDAP |
? |
? |
||||
|
PostgreSQL-Datenbank |
? |
? |
||||
|
Qpid |
? |
? |
||||
|
Nginx-Router |
? |
? |
? |
|||
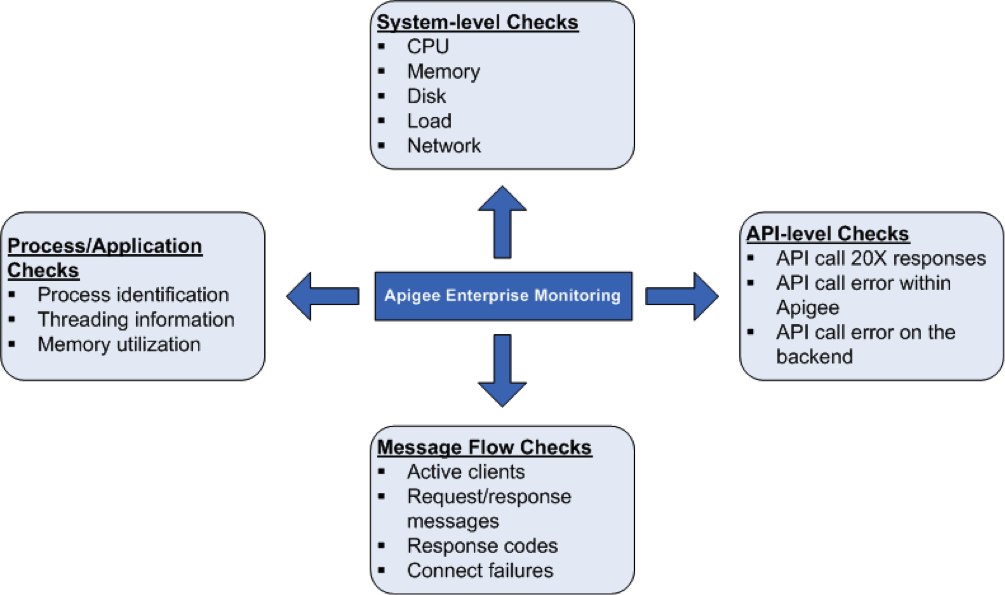
Nach der Installation von Apigee Edge können Sie im Allgemeinen die folgenden Monitoring-Aufgaben ausführen, um die Leistung einer Apigee Edge for Private Cloud-Installation zu verfolgen.
Systemdiagnosen
Es ist sehr wichtig, die Systemstatusparameter wie CPU-Auslastung, Arbeitsspeicherauslastung und Portkonnektivität auf einer höheren Ebene zu messen. Sie können die folgenden Parameter überwachen, um die Grundlagen des Systemzustands zu erhalten.
- CPU-Auslastung: Gibt die grundlegenden Statistiken (Nutzer/System/E/A-Wartezeit/Inaktiv) zur CPU-Auslastung an. Beispiel: die vom System insgesamt verwendete CPU.
- Verfügbarer/verwendeter Arbeitsspeicher: Gibt die Auslastung des Systemspeichers in Byte an. Beispiel: Vom System verwendeter physischer Arbeitsspeicher.
- Speicherplatznutzung: Gibt die Dateisysteminformationen basierend auf der aktuellen Laufwerksnutzung an. Beispiel: Vom System belegter Speicherplatz.
- Durchschnittliche Auslastung: Gibt die Anzahl der Prozesse an, die auf die Ausführung warten.
- Netzwerkstatistiken: Übertragene und empfangene Netzwerkpakete und/oder Byte sowie Übertragungsfehler für eine bestimmte Komponente.
Prozesse/Anwendungsprüfungen
Auf Prozessebene können Sie wichtige Informationen zu allen laufenden Prozessen aufrufen. Dazu gehören beispielsweise Statistiken zur Arbeitsspeicher- und CPU-Auslastung, die von einem Prozess oder einer Anwendung verwendet werden. Für Prozesse wie qpidd, postgres postmaster, java usw. können Sie Folgendes überwachen:
- Prozessidentifikation: Identifizieren Sie einen bestimmten Apigee-Prozess. Sie können beispielsweise prüfen, ob ein Java-Prozess des Apigee-Servers vorhanden ist.
- Thread-Statistiken: Hier sehen Sie die zugrunde liegenden Threading-Muster, die ein Prozess verwendet. Sie können beispielsweise die maximale Threadanzahl und die Threadanzahl für alle Prozesse überwachen.
- Speicherauslastung: Zeigt die Speichernutzung für alle Apigee-Prozesse an. Sie können beispielsweise Parameter wie die Heap-Arbeitsspeichernutzung und die Nicht-Heap-Arbeitsspeichernutzung eines Prozesses überwachen.
Prüfungen auf API-Ebene
Auf API-Ebene können Sie prüfen, ob der Server für häufig verwendete API-Aufrufe, die von Apigee weitergeleitet werden, aktiv ist. Sie können beispielsweise eine API-Prüfung auf dem Management Server, Router und Message Processor durchführen, indem Sie den folgenden cURL-Befehl aufrufen:
curl http://<host>:<port>/v1/servers/self/up
Dabei ist <host> die IP-Adresse der Apigee Edge-Komponente. Die <port>-Nummer ist für jede Edge-Komponente spezifisch. Beispiel:
Verwaltungsserver: 8080
- Router: 8081
- Message Processor: 8082
- usw.
In den folgenden Abschnitten finden Sie Informationen zum Ausführen dieses Befehls für die einzelnen Komponenten.
Dieser Aufruf gibt „true“ und „false“ zurück. Für optimale Ergebnisse können Sie API-Aufrufe auch direkt im Backend ausführen, mit dem die Apigee-Software interagiert. So können Sie schnell feststellen, ob ein Fehler in der Apigee-Softwareumgebung oder im Backend vorliegt.
Hinweis: Zum Überwachen Ihrer API-Proxys können Sie auch API Health von Apigee verwenden. API Health führt geplante Aufrufe an Ihre API-Proxys aus und benachrichtigt Sie, wenn diese fehlschlagen und wie. Wenn Aufrufe erfolgreich sind, werden in API Health die Antwortzeiten angezeigt. Sie können sogar benachrichtigt werden, wenn die Antwortlatenz hoch ist. API Health kann Aufrufe von verschiedenen Standorten auf der ganzen Welt ausführen, um das API-Verhalten zwischen Regionen zu vergleichen.
Prüfung des Nachrichtenflusses
Sie können Daten von Routern und Message Processors zu Nachrichtenflussmustern und -statistiken erfassen. So können Sie Folgendes im Blick behalten:
- Anzahl der aktiven Kunden
- Anzahl der Antworten (10X, 20X, 30X, 40X und 50X)
- Verbindungsfehler
So können Sie Dashboards für den API-Nachrichtenfluss bereitstellen. Weitere Informationen:
Router-Systemdiagnose des Message Processors
Der Router implementiert einen Systemdiagnosemechanismus, um zu ermitteln, welche Message Processor wie erwartet funktionieren. Wenn ein Message Processor als ausgefallen oder langsam erkannt wird, kann der Router den Message Processor automatisch aus der Rotation nehmen. In diesem Fall schreibt der Router eine „Mark Down“-Nachricht in die Router-Logdatei unter /opt/apigee/var/log/edge-router/logs/system.log.
Sie können die Router-Logdatei auf diese Nachrichten hin überwachen. Wenn der Router beispielsweise einen Message Processor aus der Rotation nimmt, schreibt er eine Nachricht in das Log:
2014-05-06 15:51:52,159 org: env: RPCClientClientProtocolChildGroup-RPC-0 INFO CLUSTER - ServerState.setState() : State of 2a8a0e0c-3619-416f-b037-8a42e7ad4577 is now DISCONNECTED. handle = <MP_IP> at 1399409512159

2014-04-17 12:54:48,512 org: env: nioEventLoopGroup-2-2 INFO HEARTBEAT - HBTracker.gotResponse() : No HeartBeat detected from /<MP_IP>:<PORT> Mark Down
Dabei ist /<MP_IP>:<PORT> die IP-Adresse und Portnummer des Message Processors.
Wenn der Router später eine Systemdiagnose durchführt und feststellt, dass der Message Processor ordnungsgemäß funktioniert, wird der Message Processor automatisch wieder in die Rotation aufgenommen. Der Router schreibt außerdem eine „Mark Up“-Nachricht in das Log:
2014-05-06 16:07:29,054 org: env: RPCClientClientProtocolChildGroup-RPC-0 INFO CLUSTER - ServerState.setState() : State of 2a8a0e0c-3619-416f-b037-8a42e7ad4577 is now CONNECTED. handle = <IP> at 1399410449054

2014-04-17 12:55:06,064 org: env: nioEventLoopGroup-4-1 INFO HEARTBEAT - HBTracker.updateHB() : HeartBeat detected from /<IP>:<PORT> Mark Up