

Edge for Private Cloud 4.18.01 版
一般來說,在正式環境設定中,必須在 Apigee Edge for Private Cloud 部署作業中啟用監控機制。這些監控技術會在發生錯誤或故障時,向網路管理員 (或操作員) 發出警告。產生的每個錯誤都會在 Apigee Edge 中回報為快訊。如要進一步瞭解快訊,請參閱「監控最佳做法」。
為方便起見,Apigee 元件主要分為兩類:
- Apigee 專屬 Java 伺服器服務:包括管理伺服器、訊息處理器、Qpid 伺服器和 Postgres 伺服器。
- 第三方服務:包括 Nginx Router、Apache Cassandra、Apache ZooKeeper、OpenLDAP、PostgreSQL 資料庫和 Qpid。
在 Apigee Edge 的地端部署中,下表提供可監控的參數概覽:
|
構成要素 |
系統檢查 |
程序層級統計資料 |
API 級別檢查 |
訊息流程檢查 |
元件專屬 |
|
|---|---|---|---|---|---|---|
|
Apigee 專屬 Java 服務 |
管理伺服器 |
? |
? |
? |
||
|
訊息處理器 |
? |
? |
? |
? |
||
|
Qpid 伺服器 |
? |
? |
? |
|||
|
Postgres 伺服器 |
? |
? |
? |
|||
|
第三方服務 |
Apache Cassandra |
? |
? |
|||
|
Apache ZooKeeper |
? |
? |
||||
|
OpenLDAP |
? |
? |
||||
|
PostgreSQL 資料庫 |
? |
? |
||||
|
Qpid |
? |
? |
||||
|
Nginx 路由器 |
? |
? |
? |
|||
一般來說,安裝 Apigee Edge 後,您可以執行下列監控工作,追蹤 Apigee Edge for Private Cloud 安裝作業的效能。
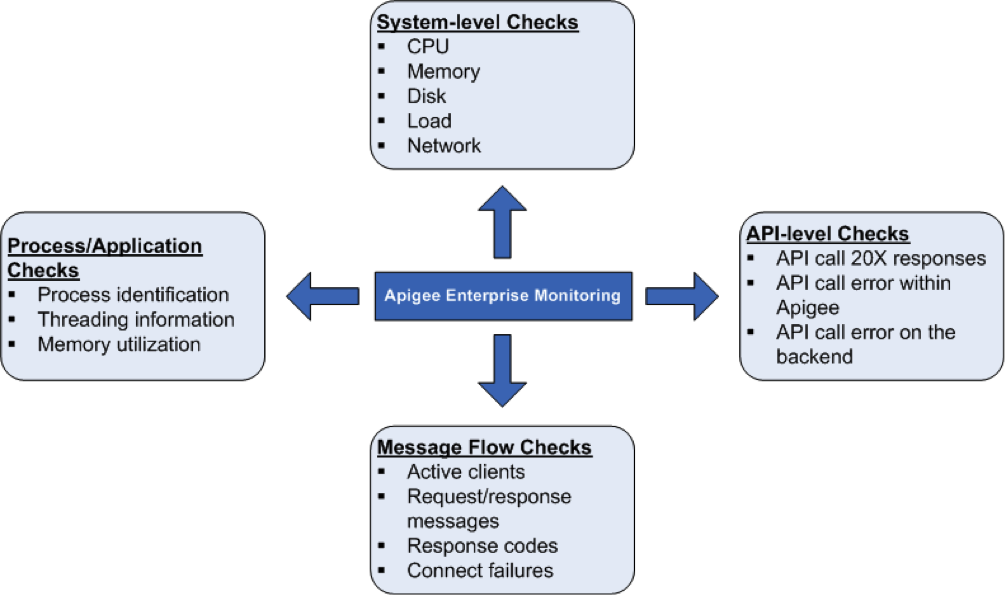
系統健康狀態檢查
請務必從較高層級評估系統健康狀態參數,例如 CPU 使用率、記憶體使用率和通訊埠連線能力。您可以監控下列參數,瞭解系統健康狀態的基本資訊。
- CPU 使用率:指定 CPU 使用率的基本統計資料 (使用者/系統/IO 等待/閒置)。例如系統使用的 CPU 總量。
- Free/Used Memory:以位元組為單位指定系統記憶體使用率。例如系統使用的實體記憶體。
- 磁碟空間用量:根據目前的磁碟用量指定檔案系統資訊。例如系統使用的磁碟空間。
- 平均負載:指定等待執行的程序數量。
- 網路統計資料:傳輸及接收的網路封包和/或位元組,以及指定元件的傳輸錯誤。
程序/應用程式檢查
在程序層級,您可以查看所有執行中程序的重要資訊。例如,這包括程序或應用程式使用的記憶體和 CPU 使用統計資料。對於 qpidd、postgres postmaster、java 等程序,您可以監控下列項目:
- 程序識別:識別特定 Apigee 程序。例如,您可以監控 Apigee 伺服器 Java 程序是否存在。
- 執行緒統計資料:查看程序使用的基礎執行緒模式。舉例來說,您可以監控所有程序的執行緒數量和執行緒數量峰值。
- 記憶體使用率:查看所有 Apigee 程序的記憶體用量。例如,您可以監控程序使用的堆積記憶體用量、非堆積記憶體用量等參數。
API 級別檢查
在 API 層級,您可以監控伺服器是否正常運作,以便處理 Apigee 代理的常用 API 呼叫。舉例來說,您可以叫用下列 cURL 指令,對管理伺服器、路由器和訊息處理器執行 API 檢查:
curl http://<host>:<port>/v1/servers/self/up
其中 <host> 是 Apigee Edge 元件的 IP 位址。<port> 編號因 Edge 元件而異。例如:
管理伺服器:8080
- 路由器:8081
- 訊息處理器:8082
- 其他
請參閱下方各節,瞭解如何為每個元件執行這項指令
這項呼叫會傳回「true」和「false」。為獲得最佳結果,您也可以直接在後端 (與 Apigee 軟體互動) 發出 API 呼叫,快速判斷錯誤是發生在 Apigee 軟體環境或後端。
注意:如要監控 API Proxy,您也可以使用 Apigee 的 API Health。API Health 會定期呼叫 API Proxy,並在呼叫失敗時通知您,以及說明失敗原因。如果呼叫成功,API Health 會顯示回應時間,甚至能在回應延遲時間過長時通知您。API Health 可從全球各地發出呼叫,比較不同區域的 API 行為。
郵件流程檢查
您可以從路由器和訊息處理器收集訊息流程模式/統計資料。您可以監控下列項目:
- 活躍用戶端數量
- 回應數量 (10X、20X、30X、40X 和 50X)
- 連線失敗
這有助於您為 API 訊息流程提供資訊主頁。詳情請參閱:
- 如何監控訊息處理器
- Apigee Monitoring 資訊主頁 Beta 版總覽:路由器
訊息處理器的路由器健康狀態檢查
路由器會實作健康狀態檢查機制,判斷哪些訊息處理器運作正常。如果偵測到訊息處理器故障或速度緩慢,路由器會自動將訊息處理器從輪替中移除。如果發生這種情況,路由器會將「Mark Down」訊息寫入路由器記錄檔,路徑為 /opt/apigee/var/log/edge-router/logs/system.log。
您可以監控路由器記錄檔,查看這些訊息。舉例來說,如果路由器將訊息處理器從輪替中移除,則會以下列格式將訊息寫入記錄:
2014-05-06 15:51:52,159 org: env: RPCClientClientProtocolChildGroup-RPC-0 INFO CLUSTER - ServerState.setState() : State of 2a8a0e0c-3619-416f-b037-8a42e7ad4577 is now DISCONNECTED. handle = <MP_IP> at 1399409512159

2014-04-17 12:54:48,512 org: env: nioEventLoopGroup-2-2 INFO HEARTBEAT - HBTracker.gotResponse() : No HeartBeat detected from /<MP_IP>:<PORT> Mark Down
其中 /<MP_IP>:<PORT> 是訊息處理器的 IP 位址和通訊埠號碼。
如果路由器之後執行健康狀態檢查,並判定訊息處理器運作正常,路由器會自動將訊息處理器放回輪替。路由器也會將「Mark Up」訊息寫入記錄,格式如下:
2014-05-06 16:07:29,054 org: env: RPCClientClientProtocolChildGroup-RPC-0 INFO CLUSTER - ServerState.setState() : State of 2a8a0e0c-3619-416f-b037-8a42e7ad4577 is now CONNECTED. handle = <IP> at 1399410449054

2014-04-17 12:55:06,064 org: env: nioEventLoopGroup-4-1 INFO HEARTBEAT - HBTracker.updateHB() : HeartBeat detected from /<IP>:<PORT> Mark Up