

Edge for Private Cloud v4.18.01
בדרך כלל, בהגדרה של סביבת ייצור צריך להפעיל מנגנוני מעקב בפריסה של Apigee Edge for Private Cloud. שיטות המעקב האלה מתריעות למנהלי הרשת (או למפעילים) על שגיאה או כשל. כל שגיאה שנוצרת מדווחת כהתראה ב-Apigee Edge. מידע נוסף על התראות זמין במאמר שיטות מומלצות למעקב.
כדי להקל על השימוש, הרכיבים של Apigee מסווגים בעיקר לשתי קטגוריות:
- שירותי שרת Java ספציפיים ל-Apigee – כוללים את Management Server, מעבד בקשות, Qpid Server ו-Postgres Server.
- שירותים של צד שלישי – כוללים את Nginx Router, Apache Cassandra, Apache ZooKeeper, OpenLDAP, מסד נתונים של PostgreSQL ו-Qpid.
בפריסה מקומית של Apigee Edge, בטבלה הבאה מפורטים בקצרה הפרמטרים שאפשר לעקוב אחריהם:
|
רכיב |
בדיקות מערכת |
נתונים סטטיסטיים ברמת התהליך |
בדיקות ברמת ה-API |
בדיקות של זרימת ההודעות |
ספציפי לרכיב |
|
|---|---|---|---|---|---|---|
|
שירותי Java ספציפיים ל-Apigee |
שרת ניהול |
? |
? |
? |
||
|
מעבד בקשות |
? |
? |
? |
? |
||
|
שרת Qpid |
? |
? |
? |
|||
|
שרת Postgres |
? |
? |
? |
|||
|
שירותים של צד שלישי |
Apache Cassandra |
? |
? |
|||
|
Apache ZooKeeper |
? |
? |
||||
|
OpenLDAP |
? |
? |
||||
|
מסד נתונים של PostgreSQL |
? |
? |
||||
|
Qpid |
? |
? |
||||
|
נתב Nginx |
? |
? |
? |
|||
באופן כללי, אחרי שמתקינים את Apigee Edge, אפשר לבצע את משימות המעקב הבאות כדי לעקוב אחרי הביצועים של התקנת Apigee Edge for Private Cloud.
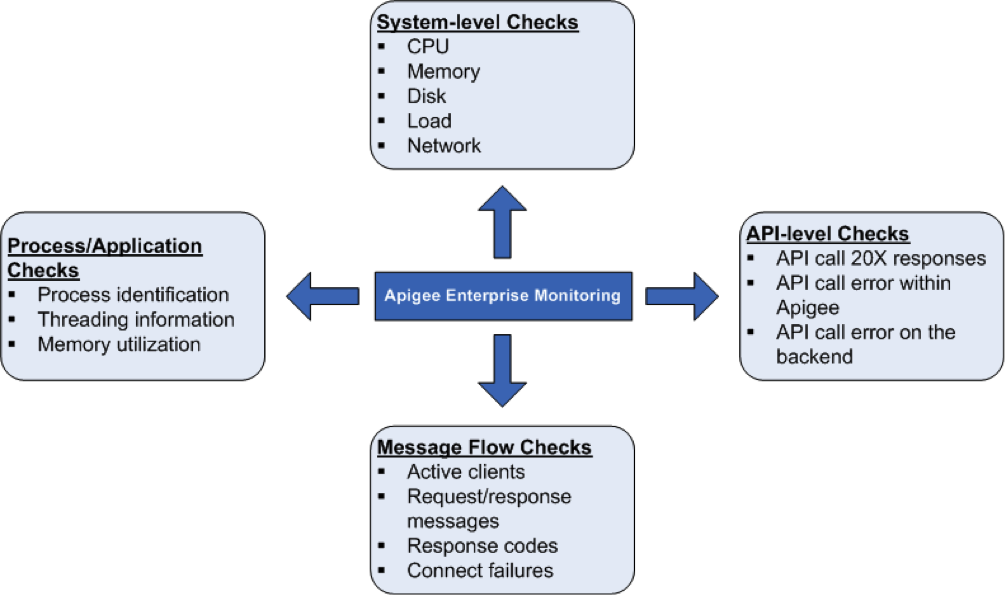
בדיקות תקינות של המערכת
חשוב מאוד למדוד את הפרמטרים של תקינות המערכת, כמו ניצול המעבד (CPU), ניצול הזיכרון וקישוריות היציאות ברמה גבוהה יותר. כדי לקבל מידע בסיסי על תקינות המערכת, אפשר לעקוב אחרי הפרמטרים הבאים:
- CPU Utilization – מציין את הנתונים הסטטיסטיים הבסיסיים (User/System/IO Wait/Idle) לגבי ניצול המעבד (CPU). לדוגמה, סך השימוש במעבד (CPU) על ידי המערכת.
- Free/Used Memory – ניצול זיכרון המערכת בבייטים. לדוגמה, הזיכרון הפיזי שמשמש את המערכת.
- Disk Space Usage – פרטי מערכת הקבצים על סמך השימוש הנוכחי במקום בכונן. לדוגמה, מקום בכונן הקשיח שמשמש את המערכת.
- Load Average – מציין את מספר התהליכים שממתינים להפעלה.
- נתונים סטטיסטיים של הרשת – חבילות נתונים ו/או בייטים של הרשת שנשלחו והתקבלו, יחד עם שגיאות השידור של רכיב מסוים.
בדיקות של תהליכים או אפליקציות
ברמת התהליך, אפשר לראות מידע חשוב על כל התהליכים שפועלים. לדוגמה, נתוני שימוש בזיכרון ובמעבד (CPU) על ידי תהליך או אפליקציה. לתהליכים כמו qpidd, postgres postmaster, java וכו', אפשר לעקוב אחרי:
- זיהוי תהליך: זיהוי תהליך ספציפי של Apigee. לדוגמה, אתם יכולים לעקוב אחרי קיומו של תהליך Java בשרת Apigee.
- נתונים סטטיסטיים של שרשורים: הצגת דפוסי השרשורים הבסיסיים שבהם משתמש התהליך. לדוגמה, אתם יכולים לעקוב אחרי מספר השרשורים המקסימלי, מספר השרשורים של כל התהליכים.
- ניצול זיכרון: הצגת השימוש בזיכרון בכל התהליכים של Apigee. לדוגמה, אפשר לעקוב אחרי פרמטרים כמו השימוש בזיכרון הערימה והשימוש בזיכרון שאינו ערימה בתהליך מסוים.
בדיקות ברמת ה-API
ברמת ה-API, אתם יכולים לבדוק אם השרת פועל בקריאות ל-API שנעשה בהן שימוש תכוף, שמועברות דרך שרת proxy באמצעות Apigee. לדוגמה, אפשר לבצע בדיקת API בשרת הניהול, בנתב ובמעבד הבקשות באמצעות הפעלת פקודת ה-cURL הבאה:
curl http://<host>:<port>/v1/servers/self/up
כאשר <host> הוא כתובת ה-IP של רכיב Apigee Edge. מספר ה-<port> הוא ספציפי לכל רכיב של Edge. לדוגמה:
שרת ניהול: 8080
- נתב: 8081
- מעבד בקשות: 8082
- וכו'
בקטעים הבאים מוסבר איך להריץ את הפקודה הזו לכל רכיב.
הקריאה הזו מחזירה את הערכים "true" ו-"false". כדי לקבל את התוצאות הכי טובות, אפשר גם להנפיק קריאות ל-API ישירות בקצה העורפי (שתוכנת Apigee פועלת איתו) כדי לקבוע במהירות אם יש שגיאה בסביבת התוכנה של Apigee או בקצה העורפי.
הערה: כדי לעקוב אחרי שרתי ה-proxy ל-API, אתם יכולים גם להשתמש ב-API Health של Apigee. הכלי API Health מבצע קריאות מתוזמנות ל-proxy ל-API, ומודיע לכם אם הן נכשלו ואיך. כשהקריאות מצליחות, ב-API Health מוצגים זמני התגובה, ואפילו אפשר לקבל התראה כשיש זמן אחזור ארוך. API Health יכול לבצע קריאות ממיקומים שונים ברחבי העולם כדי להשוות בין ההתנהגות של ה-API באזורים שונים.
בדיקות של זרימת ההודעות
אתם יכולים לאסוף נתונים מנתבים וממעבדי בקשות לגבי דפוסים או נתונים סטטיסטיים של זרימת ההודעות. כך אפשר לעקוב אחרי:
- מספר הלקוחות הפעילים
- מספר התשובות (פי 10, פי 20, פי 30, פי 40 ופי 50)
- חיבורים שנכשלו
כך תוכלו לספק לוחות בקרה לזרימת ההודעות ב-API. מידע נוסף זמין במאמרים הבאים:
- איך עוקבים אחרי מעבד הבקשות
- סקירה כללית של Apigee Monitoring Dashboard Beta לנתב
בדיקת תקינות של הנתב של מעבד הבקשות
הנתב מיישם מנגנון של בדיקת תקינות כדי לקבוע אילו ממעבדי הבקשות פועלים כמו שצריך. אם המערכת מזהה שמעבד בקשות מושבת או איטי, הנתב יכול להוציא אותו אוטומטית מהרוטציה. במקרה כזה, הנתב כותב הודעות Mark Down בקובץ היומן של הנתב ב-/opt/apigee/var/log/edge-router/logs/system.log.
אפשר לעקוב אחרי קובץ היומן של הנתב כדי לראות את ההודעות האלה. לדוגמה, אם הנתב מוציא מעבד בקשות מהסבב, הוא כותב הודעה ביומן בפורמט הבא:
2014-05-06 15:51:52,159 org: env: RPCClientClientProtocolChildGroup-RPC-0 INFO CLUSTER - ServerState.setState() : State of 2a8a0e0c-3619-416f-b037-8a42e7ad4577 is now DISCONNECTED. handle = <MP_IP> at 1399409512159

2014-04-17 12:54:48,512 org: env: nioEventLoopGroup-2-2 INFO HEARTBEAT - HBTracker.gotResponse() : No HeartBeat detected from /<MP_IP>:<PORT> Mark Down
כאשר /<MP_IP>:<PORT> הוא כתובת ה-IP ומספר היציאה של מעבד הבקשות.
אם בהמשך הנתב מבצע בדיקת תקינות וקובע שמעבד הבקשות פועל כראוי, הנתב מחזיר באופן אוטומטי את מעבד הבקשות לסבב. Router גם כותב הודעת "Mark Up" ביומן בפורמט הבא:
2014-05-06 16:07:29,054 org: env: RPCClientClientProtocolChildGroup-RPC-0 INFO CLUSTER - ServerState.setState() : State of 2a8a0e0c-3619-416f-b037-8a42e7ad4577 is now CONNECTED. handle = <IP> at 1399410449054

2014-04-17 12:55:06,064 org: env: nioEventLoopGroup-4-1 INFO HEARTBEAT - HBTracker.updateHB() : HeartBeat detected from /<IP>:<PORT> Mark Up