

Vous consultez la documentation Apigee Edge.
Accédez à la
documentation**Apigee X**. info
Problème constaté
Le déploiement des révisions de proxy d'API via l'interface utilisateur Edge ou l'appel d'API de gestion Edge échoue avec le
error "Error while accessing datastore".
Messages d'erreur
Error in deployment for environment qa.

The revision is deployed, but traffic cannot flow. Error while accessing datastore;Please retry later
Causes possibles :
Les causes typiques de ce problème sont les suivantes :
-
Cause Détails Pour Problème de connectivité réseau entre le processeur de messages et Cassandra Échec de la communication entre le processeur de messages et Cassandra en raison de problèmes de connectivité réseau ou de règles de pare-feu. Utilisateurs du cloud privé Edge Erreurs de déploiement dues aux redémarrages de Cassandra Un ou plusieurs nœuds Cassandra n'étaient pas disponibles, car ils ont été redémarrés dans le cadre d'une maintenance de routine. Utilisateurs du cloud privé Edge Pic de latence des demandes de lecture sur Cassandra Si un ou plusieurs nœuds Cassandra effectuent un grand nombre de lectures simultanées, ils peuvent répondre lentement en raison d'un pic de latence des demandes de lecture. Utilisateurs du cloud privé Edge Groupe de proxys d'API de plus de 15 Mo Cassandra a été configuré pour n'autoriser que les groupes de proxys d'API d'une taille maximale de 15 Mo en taille. Utilisateurs du cloud privé Edge Problème de connectivité réseau entre le processeur de messages et Cassandra
Diagnostic
Remarque : Seuls les utilisateurs du cloud privé Edge peuvent effectuer les étapes suivantes. Si vous utilisez le cloud public Edge, contactez l'assistance Apigee Edge.
- Annulez le déploiement du proxy d'API, puis redéployez-le. Si un problème de connectivité temporaire s'est produit
entre le processeur de messages et Cassandra, l'erreur peut disparaître.
AVERTISSEMENT : N'annulez pas le déploiement si les erreurs s'affichent dans l'environnement de production.
- Si le problème persiste, exécutez l'appel d'API de gestion ci-dessous pour vérifier l'état du
déploiement et voir si des erreurs se sont produites sur des composants :
curl -u sysadmin@email.com https://management:8080/v1/o/<org>/apis/<api>/deployments
Exemple de résultat d'état de déploiement indiquant une erreur lors de l'accès au datastore sur l'un des processeurs de messages
{
"environment" : [ {
"aPIProxy" : [ {
"name" : "simple-python",
"revision" : [ {
"configuration" : {
"basePath" : "/",
"steps" : [ ]
},
"name" : "1",
"server" : [ {
"status" : "deployed",
"type" : [ "message-processor" ],
"uUID" : "2acdd9b2-17de-4fbb-8827-8a2d4f3d7ada"
}, {
"error" : "Error while accessing datastore;Please retry later",
"errorCode" : "datastore.ErrorWhileAccessingDataStore",
"status" : "error",
"type" : [ "message-processor" ],
"uUID" : "42772085-ca67-49bf-a9f1-c04f2dc1fce3"
}
"state" : "error"
}
- Redémarrez le ou les processeurs de messages qui affichent l'erreur de déploiement. Si un problème réseau temporaire s'est produit, l'erreur devrait disparaître :
/opt/apigee/apigee-service/bin/apigee-service edge-message-processor restart
- Répétez l'étape 2 pour voir si le déploiement réussit sur le processeur de messages qui a été redémarré. Si aucune erreur n'est détectée, cela signifie que le problème est résolu.
- Vérifiez si le processeur de messages peut se connecter à chaque nœud Cassandra sur les ports 9042
et 9160:
- Si Telnet est disponible, utilisez-le :
telnet <Cassandra_IP> 9042
telnet <Cassandra_IP> 9160
- Si Telnet n'est pas disponible, utilisez Netcat pour vérifier la connectivité comme suit :
nc -vz <Cassandra_IP> 9042
nc -vz <Cassandra_IP> 9160
- Si vous recevez la réponse "Connection Refused" (Connexion refusée) ou "Connection timed out" (Délai de connexion expiré), contactez votre équipe d’opérations réseau.
- Si Telnet est disponible, utilisez-le :
- Si le problème persiste, vérifiez si chacun des nœuds Cassandra écoute sur le
port 9042 et le port 9160 :
netstat -an | grep LISTEN | grep 9042
netstat -an | grep LISTEN | grep 9160
- Si les nœuds Cassandra n'écoutent pas sur les ports 9042 ou 9160, redémarrez le
ou les nœuds Cassandra spécifiques :
/opt/apigee/apigee-service/bin/apigee-service apigee-cassandra restart
- Si le problème persiste, contactez votre équipe d'opérations réseau.
- Annulez le déploiement du proxy d'API, puis redéployez-le. Si un problème de connectivité temporaire s'est produit
entre le processeur de messages et Cassandra, l'erreur peut disparaître.
Solution
Collaborez avec votre équipe d'opérations réseau pour résoudre le problème de connectivité réseau entre le processeur de messages et Cassandra.
Erreurs de déploiement dues aux redémarrages de Cassandra
Les nœuds Cassandra sont généralement redémarrés périodiquement dans le cadre d'une maintenance de routine. Si des proxys d'API sont déployés pendant la maintenance de Cassandra, les déploiements échouent, car le datastore Cassandra est inaccessible.
Remarque : Seuls les utilisateurs du cloud privé Edge peuvent effectuer les étapes suivantes. Si vous utilisez le cloud public Edge, contactez l'assistance Apigee Edge.
Diagnostic
- Vérifiez si les nœuds Cassandra ont été redémarrés au moment du déploiement.Pour ce faire,
consultez le journal Cassandra ou les journaux d'heure de démarrage les plus récents du nœud Cassandra :
grep"shutdown"/opt/apigee/var/log/apigee-cassandra/system.log
Solution
- Assurez-vous que Cassandra est opérationnel.
- Vérifiez si les processeurs de messages peuvent se connecter au datastore Cassandra sur les ports 9042 et 9160.
Pic de latence des demandes de lecture sur Cassandra
Un nombre élevé de lectures sur Cassandra dépend des cas d'utilisation individuels et des modèles de trafic sur les proxys qui contiennent des règles nécessitant un accès en lecture à partir de Cassandra.
Par exemple, si un appel GET au type d'autorisation refresh_token est effectué pour les règles OAuth et que le jeton d'actualisation est associé à de nombreux jetons d'accès, cela peut entraîner un grand nombre de lectures à partir de Cassandra. Cela peut entraîner une augmentation de la latence des demandes de lecture sur Cassandra.
Diagnostic
Remarque : Seuls les utilisateurs du cloud privé Edge peuvent effectuer les étapes suivantes. Si vous utilisez le cloud public Edge, contactez l'assistance Apigee Edge.
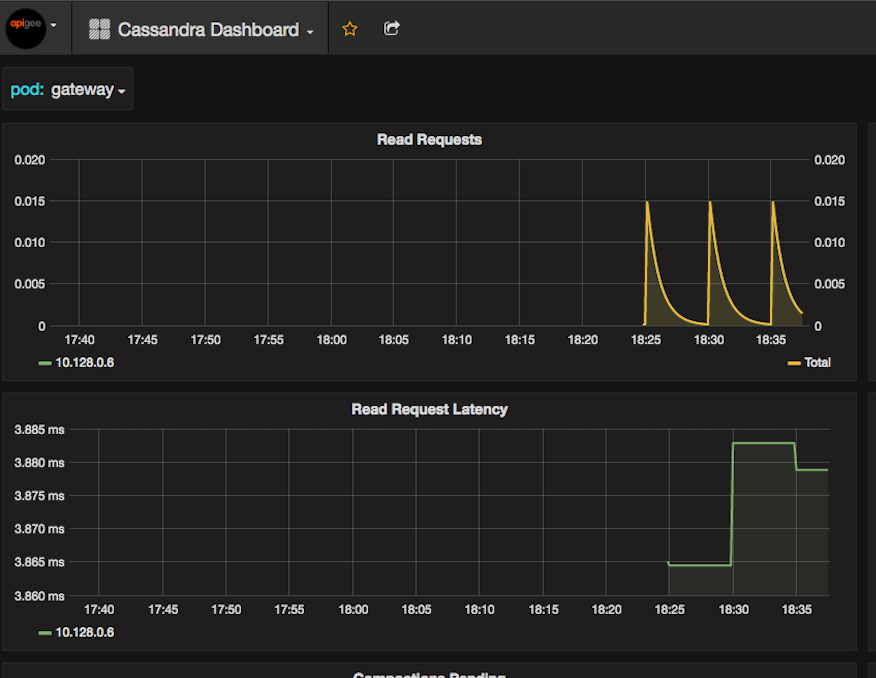
- Si vous avez installé le tableau de bord de surveillance bêta, consultez le tableau de bord Cassandra et examinez le graphique "Read Requests" (Demandes de lecture) pour la période du problème. Consultez également le graphique "Read Request Latencies" (Latences des demandes de lecture).
- L'outil alternatif pour vérifier les demandes de lecture et les latences de lecture est la commande
nodetool
    cfstats
. Pour en savoir plus sur l'utilisation de cette commande, consultez la documentation Cassandra.
Solution
Remarque : Seuls les utilisateurs du cloud privé Edge peuvent effectuer les étapes suivantes. Si vous utilisez le cloud public Edge, contactez l'assistance Apigee Edge.
- Réessayez le déploiement une fois que les performances de Cassandra sont revenues à la normale. Assurez-vous que l'anneau Cassandra entier est normal.
- (Facultatif) Effectuez un redémarrage progressif sur les processeurs de messages pour vous assurer que la connectivité est établie.
- Pour une solution à long terme, examinez les modèles de trafic d'API qui pourraient contribuer à un plus grand nombre de lectures dans le datastore Cassandra. Contactez l'assistance Apigee Edge pour obtenir de l'aide sur la résolution de ce problème.
- Si le ou les nœuds Cassandra existants ne sont pas suffisants pour gérer le trafic entrant, alors augmentez la capacité matérielle ou le nombre de nœuds du datastore Cassandra de manière appropriée.
Groupe de proxys d'API de plus de 15 Mo
La taille des groupes de proxys d'API est limitée à 15 Mo sur Cassandra. Si la taille du groupe de proxys d'API est supérieure à 15 Mo, le message "Error while accessing datastore" (Erreur lors de l'accès au datastore) s'affiche lorsque vous tentez de déployer le proxy d'API.
Diagnostic
Remarque : Seuls les utilisateurs du cloud privé Edge peuvent effectuer les étapes suivantes. Si vous utilisez le cloud public Edge, contactez l'assistance Apigee Edge.
- Consultez les journaux du processeur de messages
(
/opt/apigee/var/log/edge-message-processor/logs/system.log) et vérifiez si des erreurs se sont produites lors du déploiement du proxy d'API spécifique. - Si une erreur semblable à celle illustrée ci-dessous s'affiche, cela signifie que l'erreur de déploiement
est due au fait que la taille du groupe de proxys d'API est supérieure à 15 Mo.
2016-03-23 18:42:18,517 main ERROR DATASTORE.CASSANDRA - AstyanaxCassandraClient.fetchDynamicCompositeColumns() : Error while querying columnfamily : [api_proxy_revisions_r21, adevegowdat@v1-node-js] for rowkey:{}
com.netflix.astyanax.connectionpool.exceptions.TransportException: TransportException: [host=None(0.0.0.0):0, latency=159(486), attempts=3]org.apache.thrift.transport.TTransportException: Frame size (20211500) larger than max length (16384000)!
        at com.netflix.astyanax.thrift.ThriftConverter.ToConnectionPoolException(ThriftConverter.java:197) ~[astyanax-thrift-1.56.43.jar:na]
        at com.netflix.astyanax.thrift.AbstractOperationImpl.execute(AbstractOperationImpl.java:65) ~[astyanax-thrift-1.56.43.jar:na]
...<snipped>
        Caused by: org.apache.thrift.transport.TTransportException: Frame size (20211500) larger than max length (16384000)!
        at org.apache.thrift.transport.TFramedTransport.readFrame(TFramedTransport.java:137) ~[libthrift-0.9.1.jar:0.9.1]
        at org.apache.thrift.transport.TFramedTransport.read(TFramedTransport.java:101) ~[libthrift-0.9.1.jar:0.9.1]
        at org.apache.thrift.transport.TTransport.readAll(TTransport.java:84) ~[libthrift-0.9.1.jar:0.9.1]
...<snipped>
Solution
Le groupe de proxys d'API est volumineux s'il contient trop de fichiers de ressources. Pour résoudre ce problème, utilisez les solutions suivantes :
Solution 1 : Déplacer les fichiers de ressources au niveau de l'environnement ou de l'organisation
- Déplacez les fichiers de ressources, tels que les fichiers et modules de script NodeJS, les fichiers JavaScript et les fichiers JAR, au niveau de l’environnement ou de l’organisation. Pour en savoir plus sur les fichiers de ressources, consultez la documentation Edge.
- Déployez le proxy d'API et vérifiez si l'erreur disparaît.
Si le problème persiste ou si vous ne pouvez pas déplacer les fichiers de ressources au niveau de l'environnement ou de l'organisation pour une raison quelconque, appliquez la solution 2.
Solution 2 : Augmenter la taille du groupe de proxys d'API sur Cassandra
Remarque : Seuls les utilisateurs du cloud privé Edge peuvent effectuer les étapes suivantes. Si vous utilisez le cloud public Edge, contactez l'assistance Apigee Edge.
Procédez comme suit pour augmenter la taille de la propriété Cassandra thrift frame transport size, qui contrôle la taille maximale du groupe de proxys d'API autorisée dans Edge :
- Si le fichier n'existe pas, créez-le :
/opt/apigee/customer/application/cassandra.properties
- Ajoutez la ligne suivante au fichier, en remplaçant <size> par le paramètre de taille nécessaire pour
le grand groupe :
conf_cassandra_thrift_framed_transport_size_in_mb=<size>
- Redémarrez Cassandra :
/opt/apigee/apigee-service/bin/apigee-service edge-management-server restart
- Répétez les étapes 1 à 3 sur tous les nœuds Cassandra du cluster.
Si le problème persiste, contactez l'assistance Apigee Edge.