

Sie lesen gerade die Dokumentation zu Apigee Edge.
Zur Dokumentation zu
Apigee X. info
Symptom
Die Clientanwendung erhält einen Zeitüberschreitungsfehler für API-Anfragen oder die Anfrage wird abrupt beendet, während die API-Anfrage noch in Apigee ausgeführt wird.
In API Monitoring und
NGINX-Zugriffslogs wird für solche API-Anfragen der Statuscode 499 angezeigt. Manchmal werden in API Analytics unterschiedliche Statuscodes angezeigt, da es dort den vom Message Processor zurückgegebenen Statuscode anzeigt.
Fehlermeldung
In Clientanwendungen können Fehler wie die folgenden auftreten:
curl: (28) Operation timed out after 6001 milliseconds with 0 out of -1 bytes received
Was verursacht Zeitüberschreitungen auf Clientseite?
Der typische Pfad für eine API-Anfrage auf der Edge-Plattform ist Client > Router > Nachrichtenprozessor > Backend-Server , wie in der folgenden Abbildung dargestellt:
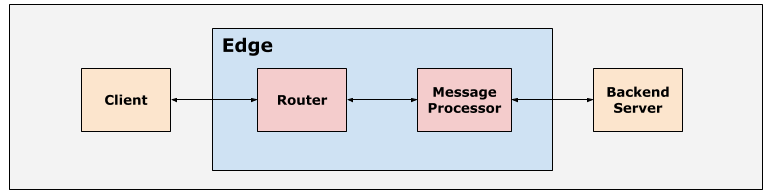
Die Router und Nachrichtenprozessoren auf der Apigee Edge-Plattform sind mit geeigneten Standardzeitüberschreitungswerten eingerichtet, damit die API-Anfragen nicht zu lange dauern.
Zeitüberschreitung auf Clientseite
Clientanwendungen können nach Bedarf mit einem geeigneten Zeitüberschreitungswert konfiguriert werden.
Für Clients wie Webbrowser und mobile Apps sind Zeitüberschreitungen durch das Betriebssystem definiert.
Zeitüberschreitung auf Routerseite
Das standardmäßige Zeitlimit, das auf Routern konfiguriert ist, beträgt 57 Sekunden. Dies ist die maximale Zeit, die ein API-Proxy ab dem Empfang der API-Anfrage in Edge bis zum Zurücksenden der Antwort ausführen kann, einschließlich der Backend-Antwort und aller ausgeführten Richtlinien. Das Standardzeitlimit kann auf den Routern und virtuellen Hosts überschrieben werden, wie unter I/O-Zeitüberschreitung auf Routern konfigurieren beschrieben.
Zeitüberschreitung auf Nachrichtenprozessorseite
Das standardmäßige Zeitlimit, das auf Nachrichtenprozessoren konfiguriert ist, beträgt 55 Sekunden. Dies ist die maximale Zeit, die der Backend-Server für die Verarbeitung der Anfrage und die Antwort an den Nachrichtenprozessor benötigt. Das Standardzeitlimit kann auf den Nachrichtenprozessoren oder im API Proxy überschrieben werden, wie unter I/O-Zeitüberschreitung auf Nachrichtenprozessoren konfigurieren beschrieben.
Wenn der Client die Verbindung mit dem Router schließt, bevor das Zeitlimit des API-Proxys abläuft, wird der Zeitüberschreitungsfehler für die jeweilige API-Anfrage angezeigt. Der Statuscode 499 Client
Closed Connection wird für solche Anfragen im Router protokolliert. Sie können ihn in API
Monitoring und NGINX-Zugriffslogs sehen.
Mögliche Ursachen
In Edge sind die typischen Ursachen für den Fehler 499 Client Closed Connection:
| Ursache | Beschreibung | Anleitungen zur Fehlerbehebung gelten für |
|---|---|---|
| Client hat die Verbindung abrupt geschlossen | Dies geschieht, wenn der Client die Verbindung schließt, weil der Endnutzer die Anfrage abbricht, bevor sie abgeschlossen ist. | Nutzer der Public und Private Cloud |
| Zeitüberschreitung der Clientanwendung | Dies geschieht, wenn das Zeitlimit der Clientanwendung abläuft, bevor der API-Proxy die Antwort verarbeiten und senden kann. Normalerweise geschieht dies, wenn das Zeitlimit des Clients kürzer als das Zeitlimit des Routers ist. | Nutzer der Public und Private Cloud |
Allgemeine Diagnoseschritte
Verwenden Sie eines der folgenden Tools/Verfahren, um diesen Fehler zu diagnostizieren:
- API-Monitoring
- NGINX-Zugriffslogs
API-Monitoring
So diagnostizieren Sie den Fehler mit API Monitoring:
- Rufen Sie die Seite Analysieren > API-Monitoring > Untersuchen auf.
- Filtern Sie nach
4xx-Fehlern und wählen Sie den Zeitraum aus. - Stellen Sie Statuscode im Verhältnis zu Zeit dar.
- Wählen Sie eine Zelle mit
499-Fehlern aus, wie unten dargestellt: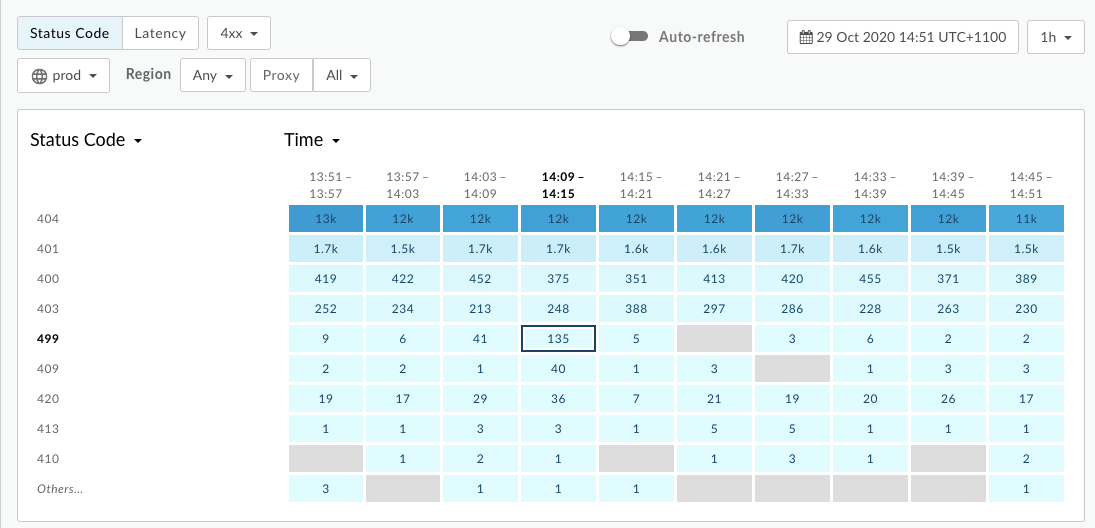
- Rechts werden die Informationen zum Fehler
499angezeigt, wie unten dargestellt: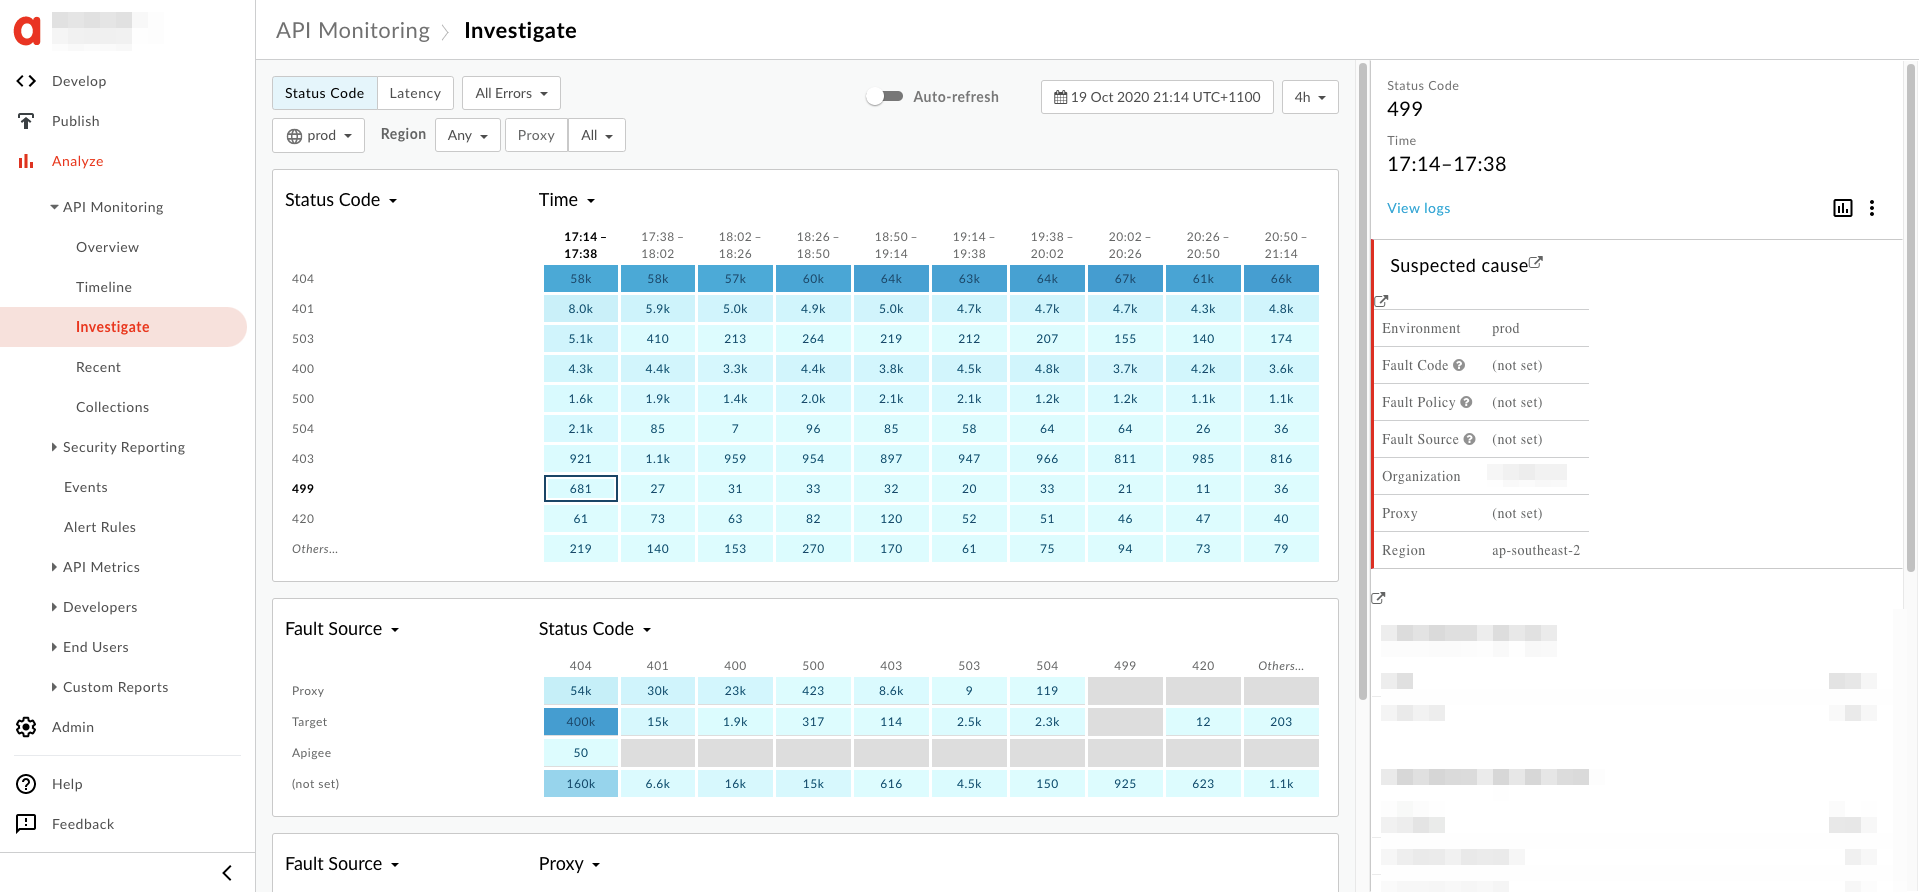
- Klicken Sie rechts auf Logs ansehen.
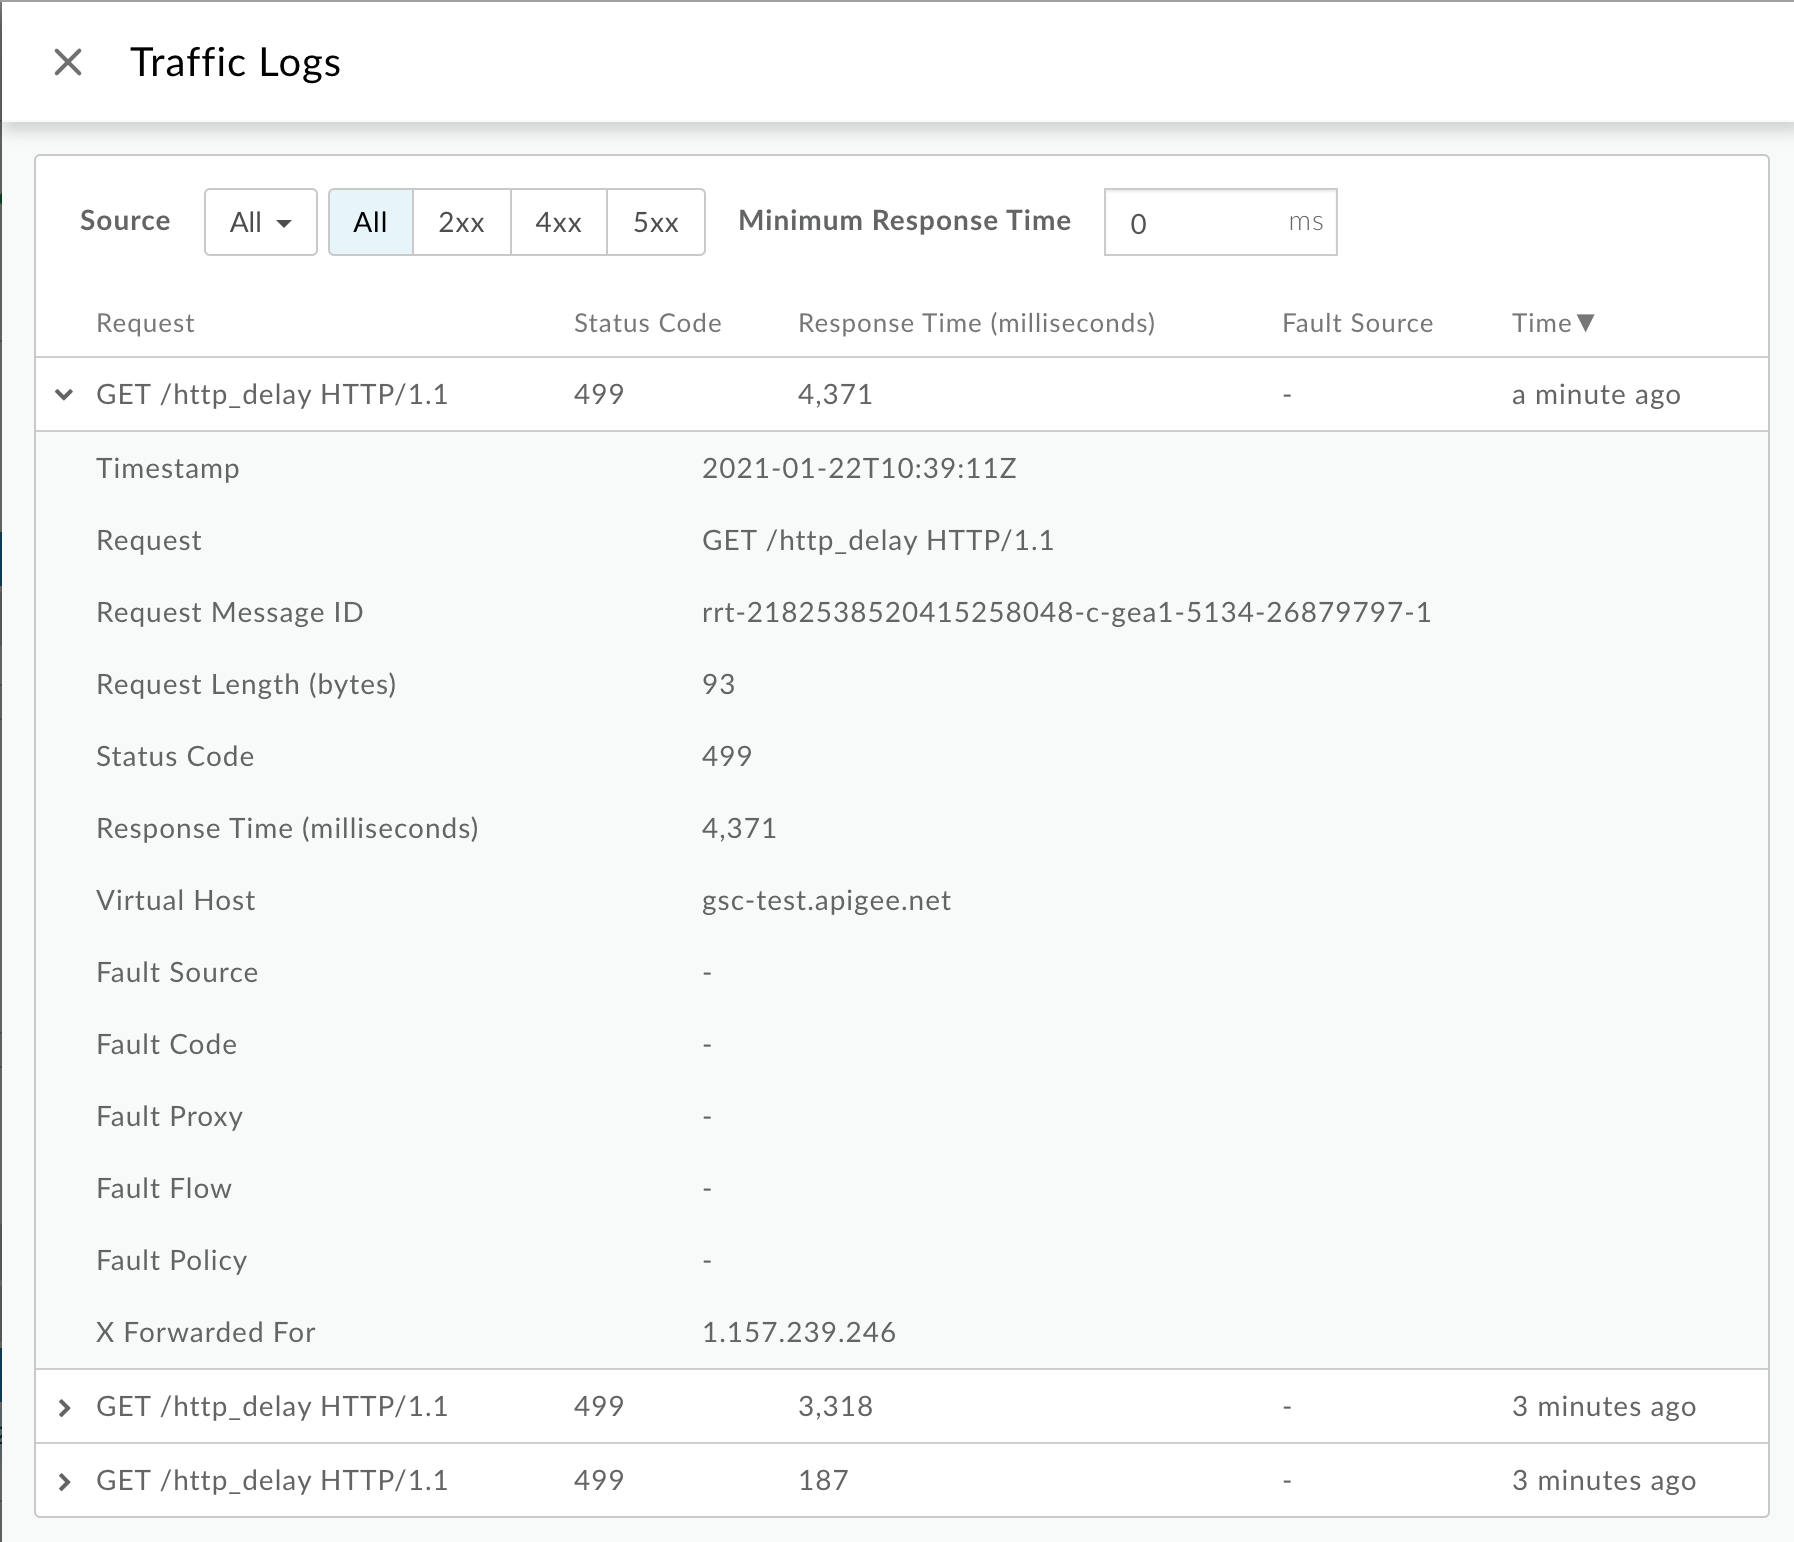
Notieren Sie sich im Fenster Traffic-Logs die folgenden Details für einige
499Fehler:- Anfrage:Hier finden Sie die Anfragemethode und den URI, die für die Aufrufe verwendet wurden.
- Antwort zeit:Hier finden Sie die für die Anfrage insgesamt verstrichene Zeit.
Sie können auch alle Logs mit der API Monitoring GET logs API abrufen. Wenn Sie beispielsweise Logs für
org,env,timeRangeundstatusabfragen, können Sie alle Logs für Transaktionen herunterladen, bei denen das Zeitlimit des Clients abgelaufen ist.Da in API Monitoring der Proxy für HTTP-
499-Fehler auf-gesetzt ist, können Sie mit der API (Logs API) den zugehörigen Proxy für den virtuellen Host und Pfad abrufen.Beispiel :
curl "https://apimonitoring.enterprise.apigee.com/logs/apiproxies?org=ORG&env=ENV&select=https://VIRTUAL_HOST/BASEBATH" -H "Authorization: Bearer $TOKEN"
- Prüfen Sie die Antwortzeit für weitere
499Fehler und prüfen Sie, ob die Antwortzeit für alle499Fehler gleich ist (z. B. 30 Sekunden).
NGINX-Zugriffslogs
So diagnostizieren Sie den Fehler mit NGINX-Zugriffslogs:
- Wenn Sie ein Private Cloud -Nutzer sind, können Sie NGINX-Zugriffslogs verwenden, um
die wichtigsten Informationen zu HTTP
499Fehlern zu ermitteln. - Prüfen Sie die NGINX-Zugriffslogs:
/opt/apigee/var/log/edge-router/nginx/ORG~ENV.PORT#_access_log - Suchen Sie, ob in einem bestimmten Zeitraum
499-Fehler aufgetreten sind (wenn das Problem in der Vergangenheit aufgetreten ist) oder ob bei Anfragen immer noch499zurückgegeben wird. - Notieren Sie sich die folgenden Informationen für einige der
499-Fehler:- Gesamtantwortzeit
- Anfrage-URI
- User-Agent
Beispiel für einen 499-Fehler aus dem NGINX-Zugriffslog :
2019-08-23T06:50:07+00:00       rrt-03f69eb1091c4a886-c-sy      50.112.119.65:47756
10.10.53.154:8443       10.001  -       -       499     -       422     0
   GET /v1/products HTTP/1.1        -       okhttp/3.9.1    api.acme.org
rrt-03f69eb1091c4a886-c-sy-13001-6496714-1
    50.112.119.65   -       -       -       -       -       -       -       -1      -       -       dc-1  router-pod-1
rt-214-190301-0020137-latest-7d
36       TLSv1.2 gateway-1     dc-1  acme    prod  https   -
In diesem Beispiel sehen wir die folgenden Informationen:
- Gesamtantwortzeit:
10.001Sekunden. Das bedeutet, dass das Zeitlimit des Clients nach 10.001 Sekunden abgelaufen ist. - Anfrage:
GET /v1/products - Host:
api.acme.org - User-Agent:
okhttp/3.9.1
- Prüfen Sie, ob die Gesamtantwortzeit und der User-Agent für alle
499Fehler gleich sind.
Ursache: Client hat die Verbindung abrupt geschlossen
Diagnose
- Wenn eine API von einer Single-Page-App aufgerufen wird, die in einem Browser oder einer mobilen Anwendung ausgeführt wird, bricht der Browser die Anfrage ab, wenn der Endnutzer den Browser plötzlich schließt, zu einer anderen Webseite im selben Tab wechselt oder das Laden der Seite durch Klicken oder Tippen auf Laden beenden beendet.
- In diesem Fall variiert die Zeit für die Verarbeitung der Anfragen (Antwortzeit) für die einzelnen Anfragen mit dem HTTP-Status
499normalerweise. -
Sie können feststellen, ob dies die Ursache ist, indem Sie die Antwortzeit vergleichen und prüfen, ob
sie für die einzelnen
499Fehler unterschiedlich ist. Verwenden Sie dazu API Monitoring oder NGINX-Zugriffs logs, wie unter Allgemeine Diagnoseschritte beschrieben.
Auflösung
- Das ist normal und in der Regel kein Grund zur Sorge, wenn die HTTP-
499-Fehler in geringer Anzahl auftreten. -
Wenn dies häufig für denselben URL-Pfad geschieht, kann das daran liegen, dass der mit diesem Pfad verknüpfte Proxy sehr langsam ist und die Nutzer nicht warten möchten.
Sobald Sie wissen, welcher Proxy betroffen sein könnte, verwenden Sie das Dashboard zur Latenz analyse, um weiter zu untersuchen, was die Proxy-Latenz verursacht.
- Ermitteln Sie in diesem Fall den betroffenen Proxy anhand der Schritte unter Allgemeine Diagnoseschritte.
- Verwenden Sie das Dashboard zur Latenzanalyse, um weiter zu untersuchen, was die Proxy-Latenz verursacht, und beheben Sie das Problem.
- Wenn Sie feststellen, dass die Latenz für den jeweiligen Proxy erwartet wird, müssen Sie Ihre Nutzer möglicherweise darüber informieren, dass die Antwort dieses Proxys einige Zeit in Anspruch nehmen wird.
Ursache: Zeitüberschreitung der Clientanwendung
Dies kann in verschiedenen Szenarien auftreten.
-
Unter normalen Betriebsbedingungen dauert es voraussichtlich eine bestimmte Zeit (z. B. 10 Sekunden), bis die Anfrage abgeschlossen ist
. Die Clientanwendung ist jedoch mit einem falschen
Zeitüberschreitungswert (z. B. 5 Sekunden) festgelegt, wodurch das Zeitlimit der Clientanwendung abläuft, bevor
die API-Anfrage abgeschlossen ist, was zu
499führt. In diesem Fall müssen wir das Zeitlimit des Clients auf einen geeigneten Wert setzen. - Ein Zielserver oder Callout dauert länger als erwartet. In diesem Fall müssen Sie die entsprechende Komponente korrigieren und auch die Zeitüberschreitungswerte entsprechend anpassen.
- Der Client benötigte die Antwort nicht mehr und hat daher abgebrochen. Dies kann bei APIs mit hoher Frequenz wie Auto-Vervollständigung oder Short Polling auftreten.
Diagnose
API Monitoring oder NGINX-Zugriffslogs
Diagnostizieren Sie den Fehler mit API Monitoring oder NGINX-Zugriffslogs:
- Prüfen Sie die API Monitoring-Logs oder NGINX-Zugriffslogs auf HTTP-
499-Transaktionen, wie unter Allgemeine Diagnoseschritte beschrieben. - Prüfen Sie, ob die Antwortzeit für alle
499-Fehler gleich ist. - Wenn ja, hat möglicherweise eine bestimmte Clientanwendung ein festes Zeitlimit
auf ihrer Seite konfiguriert. Wenn ein API-Proxy oder Zielserver langsam reagiert, läuft das Zeitlimit des Clients ab
bevor das Zeitlimit des Proxys abläuft, was zu einer großen Anzahl von HTTP
499sfür denselben URI-Pfad führt. Ermitteln Sie in diesem Fall den User-Agent aus den NGINX-Zugriffslogs, um die spezifische Clientanwendung zu ermitteln. - Es ist auch möglich, dass sich vor Apigee ein Load Balancer befindet, z. B. Akamai, F5 oder AWS ELB. Wenn Apigee hinter einem benutzerdefinierten Load Balancer ausgeführt wird, muss das Zeitlimit für Anfragen des Load Balancers länger als das Zeitlimit der Apigee API sein. Standardmäßig läuft das Zeitlimit des Apigee-Routers nach 57 Sekunden ab. Daher ist es sinnvoll, ein Zeitlimit für Anfragen von 60 Sekunden auf dem Load Balancer zu konfigurieren.
Trace
Diagnostizieren Sie den Fehler mit Trace
Wenn das Problem weiterhin besteht (499-Fehler treten immer noch auf), führen Sie die
folgenden Schritte aus:
- Aktivieren Sie die Trace-Sitzung für die betroffene API in der Edge-Benutzeroberfläche.
- Warten Sie entweder, bis der Fehler auftritt, oder wenn Sie den API-Aufruf haben, führen Sie einige API-Aufrufe aus und reproduzieren Sie den Fehler.
- Prüfen Sie die verstrichene Zeit in jeder Phase und notieren Sie sich die Phase, in der die meiste Zeit verbracht wird.
- Wenn der Fehler mit der längsten verstrichenen Zeit unmittelbar nach einer der
folgenden Phasen auftritt, ist der Backend-Server langsam oder die Verarbeitung der Anfrage dauert lange:
- Anfrage an Zielserver gesendet
- ServiceCallout-Richtlinie
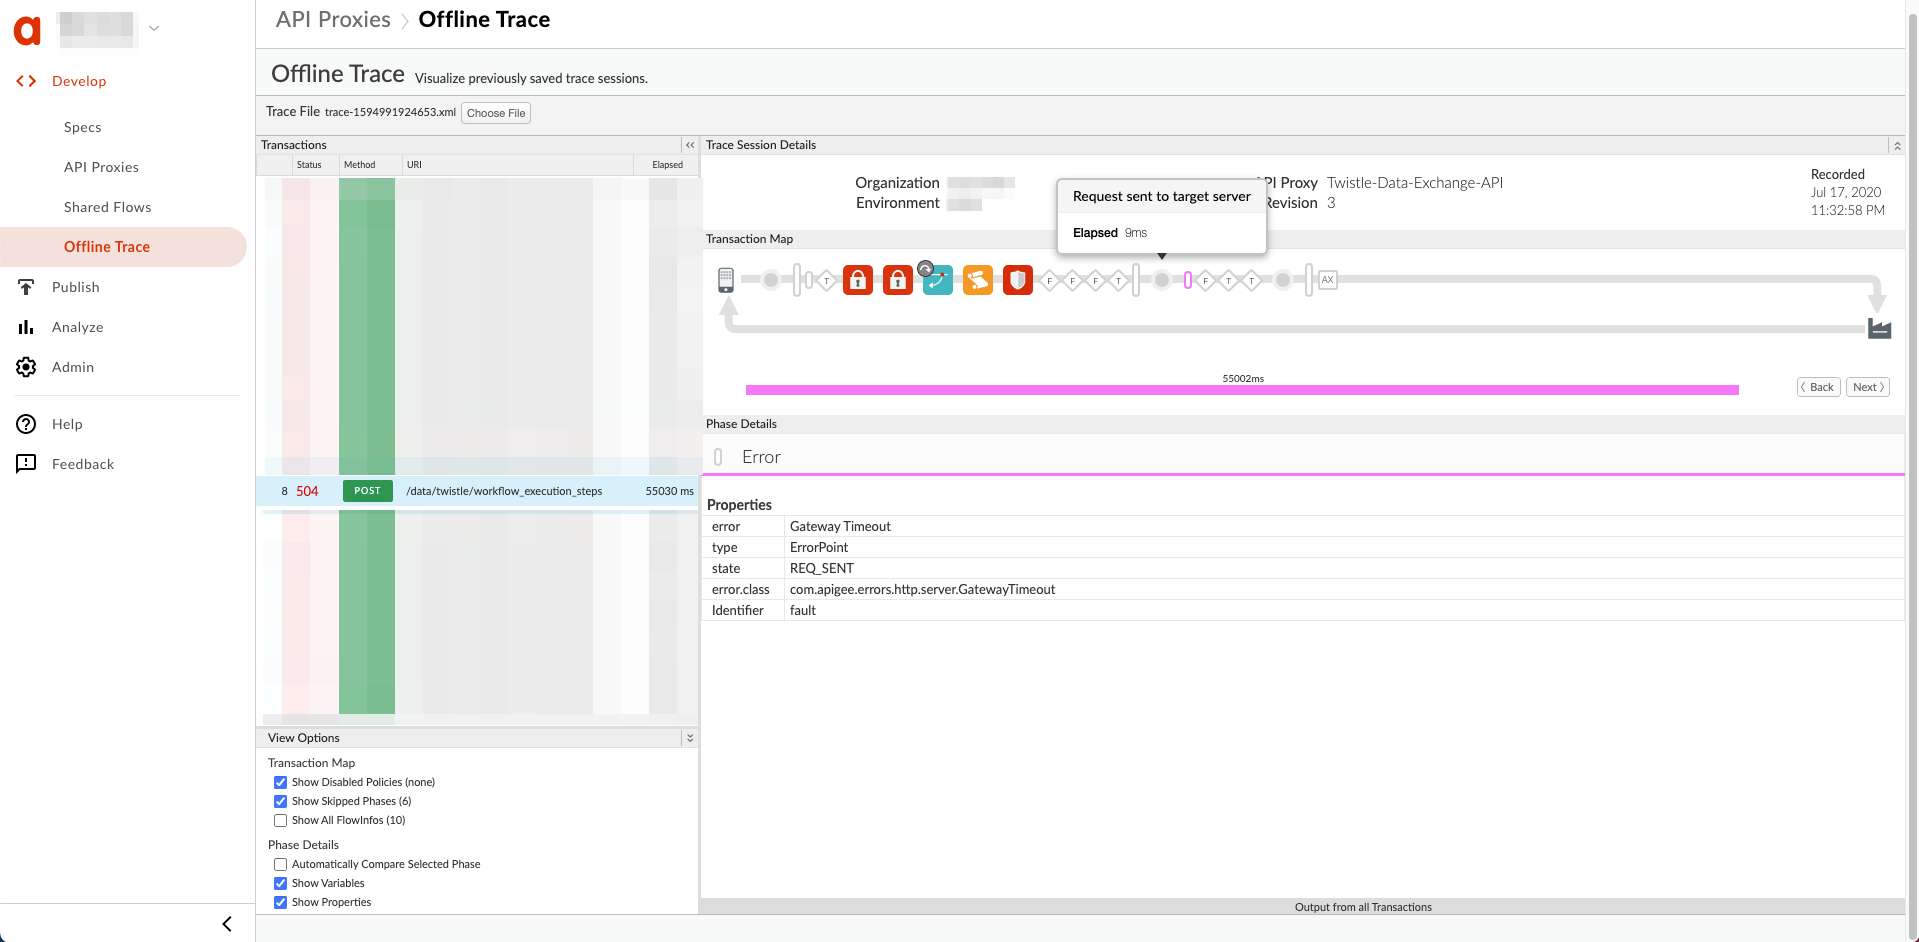
Hier sehen Sie einen Beispiel-UI-Trace, der nach dem Senden der Anfrage an den Zielserver eine Gateway-Zeitüberschreitung zeigt:
Auflösung
- Unter Empfohlene Vorgehensweisen zum Konfigurieren der I/O-Zeitüberschreitung erfahren Sie, welche Zeitüberschreitungswerte für die verschiedenen Komponenten festgelegt werden sollten, die am API-Anfrageablauf über Apigee Edge beteiligt sind.
- Legen Sie gemäß den Best Practices einen geeigneten Zeitüberschreitungswert für die Clientanwendung fest.
Wenn das Problem weiterhin besteht, lesen Sie den Abschnitt Erfassen von Diagnoseinformationen erforderlich .
Erfassen von Diagnoseinformationen erforderlich
Wenn das Problem weiterhin besteht, sammeln Sie die folgenden Diagnoseinformationen und wenden Sie sich dann an den Apigee Edge-Support.
Wenn Sie ein Public Cloud -Nutzer sind, geben Sie die folgenden Informationen an:
- Name der Organisation
- Name der Umgebung
- Name des API-Proxys
- Vollständiger
curl-Befehl zum Reproduzieren des Zeitüberschreitungsfehlers - Trace-Datei für die API-Anfragen, für die Zeitüberschreitungsfehler auf Clientseite auftreten
Wenn Sie ein Private Cloud -Nutzer sind, geben Sie die folgenden Informationen an:
- Vollständige Fehlermeldung für die fehlgeschlagenen Anfragen
- Name der Umgebung
- API-Proxy-Bundle
- Trace-Datei für die API-Anfragen, für die Zeitüberschreitungsfehler auf Clientseite auftreten
- NGINX-Zugriffslogs (
/opt/apigee/var/log/edge-router/nginx/ORG~ENV.PORT#_access_log) - Systemlogs des Nachrichtenprozessors (
/opt/apigee/var/log/edge-message-processor/logs/system.log)