

您正在查看 Apigee Edge 文档。
前往 Apigee X 文档。 信息
问题
客户端应用收到 API 请求的超时错误,或者当 API 请求仍在 Apigee 上执行时,该请求突然终止。
您将在 API 监控和 NGINX 访问日志中看到此类 API 请求的状态代码 499。有时,您会在 API 分析中看到不同的状态代码,因为该分析会显示消息处理器返回的状态代码。
出错提示
客户端应用可能会看到如下错误:
curl: (28) Operation timed out after 6001 milliseconds with 0 out of -1 bytes received
什么原因会导致客户端超时?
Edge 平台上的 API 请求的典型路径是客户端 > 路由器 > 消息处理器 > 后端服务器,如下图所示:
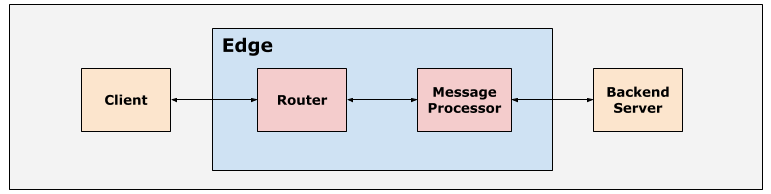
Apigee Edge 平台中的路由器和消息处理器设置了合适的默认超时值,以确保 API 请求不会花费过长时间才能完成。
客户端超时
您可以根据需要为客户端应用配置合适的超时值。
Web 浏览器和移动应用等客户端具有由操作系统定义的超时时间。
路由器超时
路由器上配置的默认超时时间为 57 秒。这是 API 代理从 Edge 收到 API 请求到发送回响应(包括后端响应和执行的所有政策)的最长执行时间。可以在路由器和虚拟主机上替换默认超时时间,如 在路由器上配置 I/O 超时中所述。
消息处理器的超时问题
在消息处理器上配置的默认超时时间为 55 秒。这是后端服务器处理请求并向消息处理器返回响应所用的最长时间。如需在消息处理器上或在 API 代理中替换默认超时,请参阅 在消息处理器上配置 I/O 超时。
如果客户端在 API 代理超时之前关闭与路由器的连接,您将看到特定 API 请求的超时错误。对于此类请求,路由器中会记录状态代码 499 Client
Closed Connection,这可以在 API Monitoring 和 NGINX 访问日志中观察到。
可能的原因
在 Edge 中,499 Client Closed Connection 错误的典型原因如下:
| 原因 | 说明 | 适用的问题排查说明 |
|---|---|---|
| 客户端突然关闭了连接 | 当最终用户在请求完成之前取消请求时,客户端会关闭连接,从而导致此错误。 | 公共云和私有云用户 |
| 客户端应用超时 | 当客户端应用在 API 代理有时间处理和发送响应之前超时时,就会发生这种情况。这种情况通常会在客户端超时时间小于路由器超时时间时发生。 | 公共云和私有云用户 |
常见诊断步骤
您可以使用以下工具/方法来诊断此错误:
- API 监控
- NGINX 访问日志
API 监控
如需使用 API 监控功能诊断错误,请执行以下操作:
- 前往分析 > API 监控 > 调查页面。
- 过滤
4xx错误并选择时间范围。 - 绘制状态代码与时间的对比图。
- 选择包含
499错误的单元格,如下所示: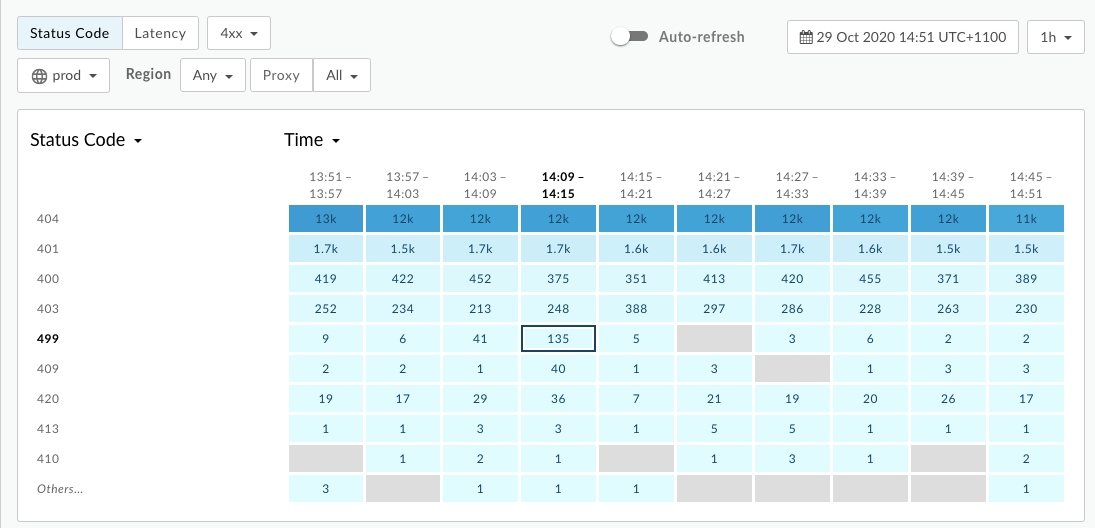
- 您将在右侧窗格中看到有关
499错误的信息,如下所示: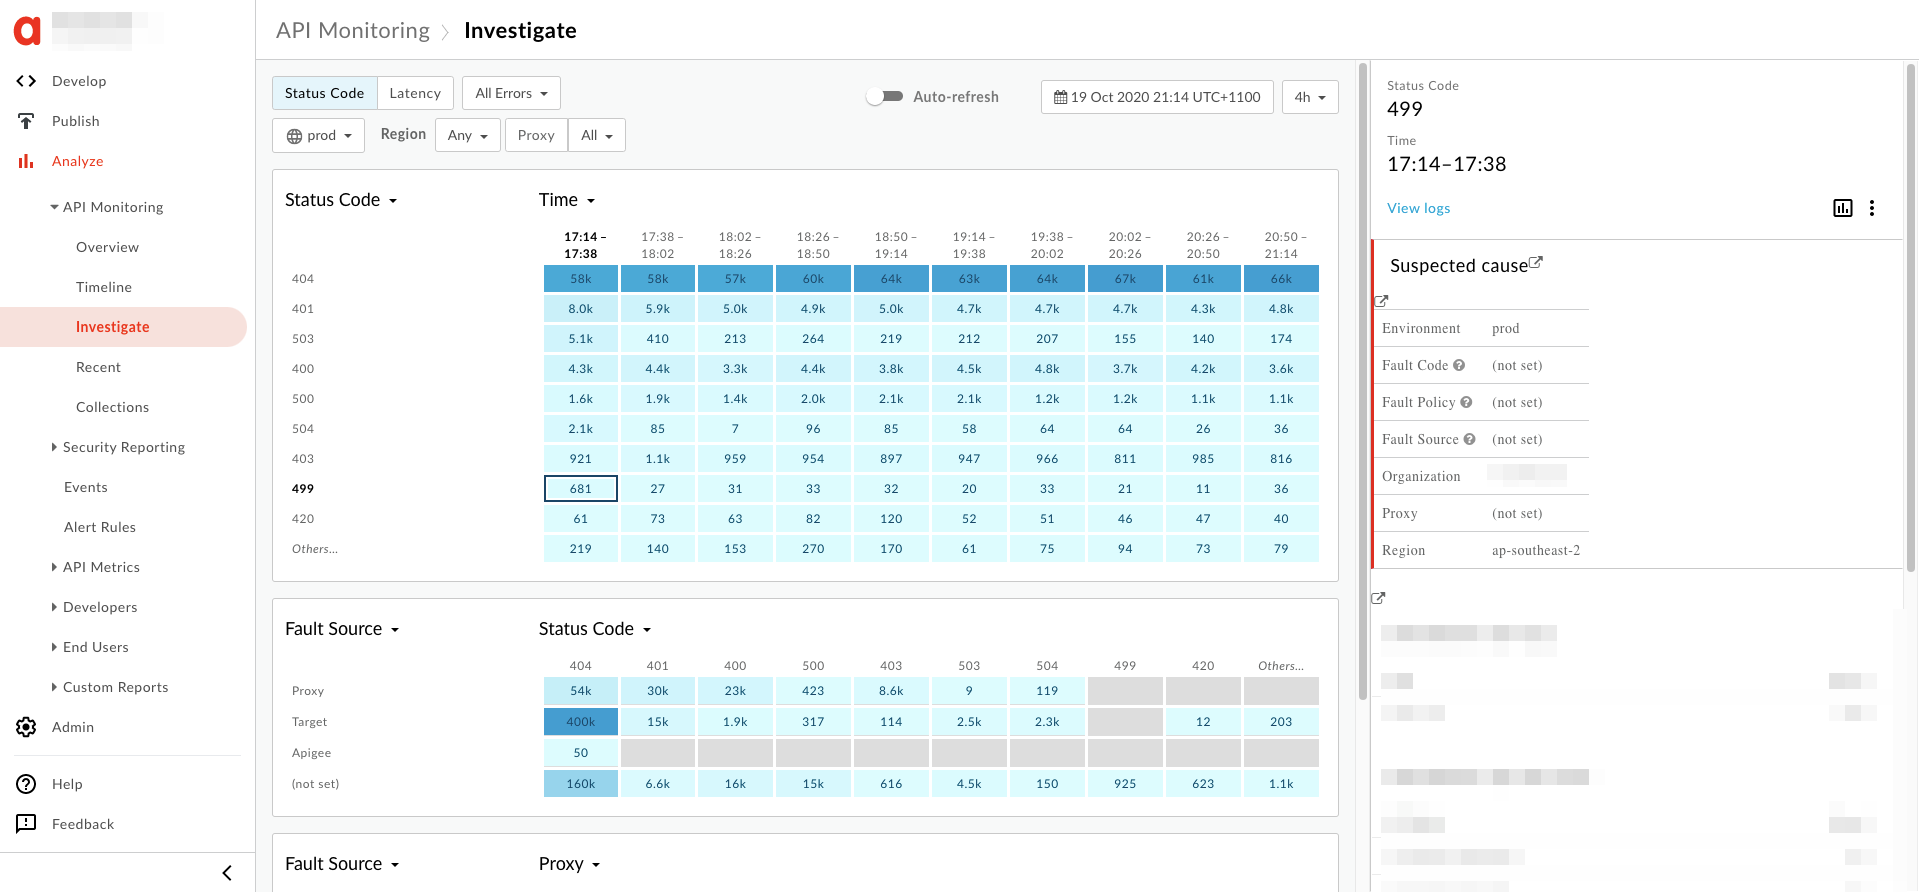
- 在右侧窗格中,点击查看日志。
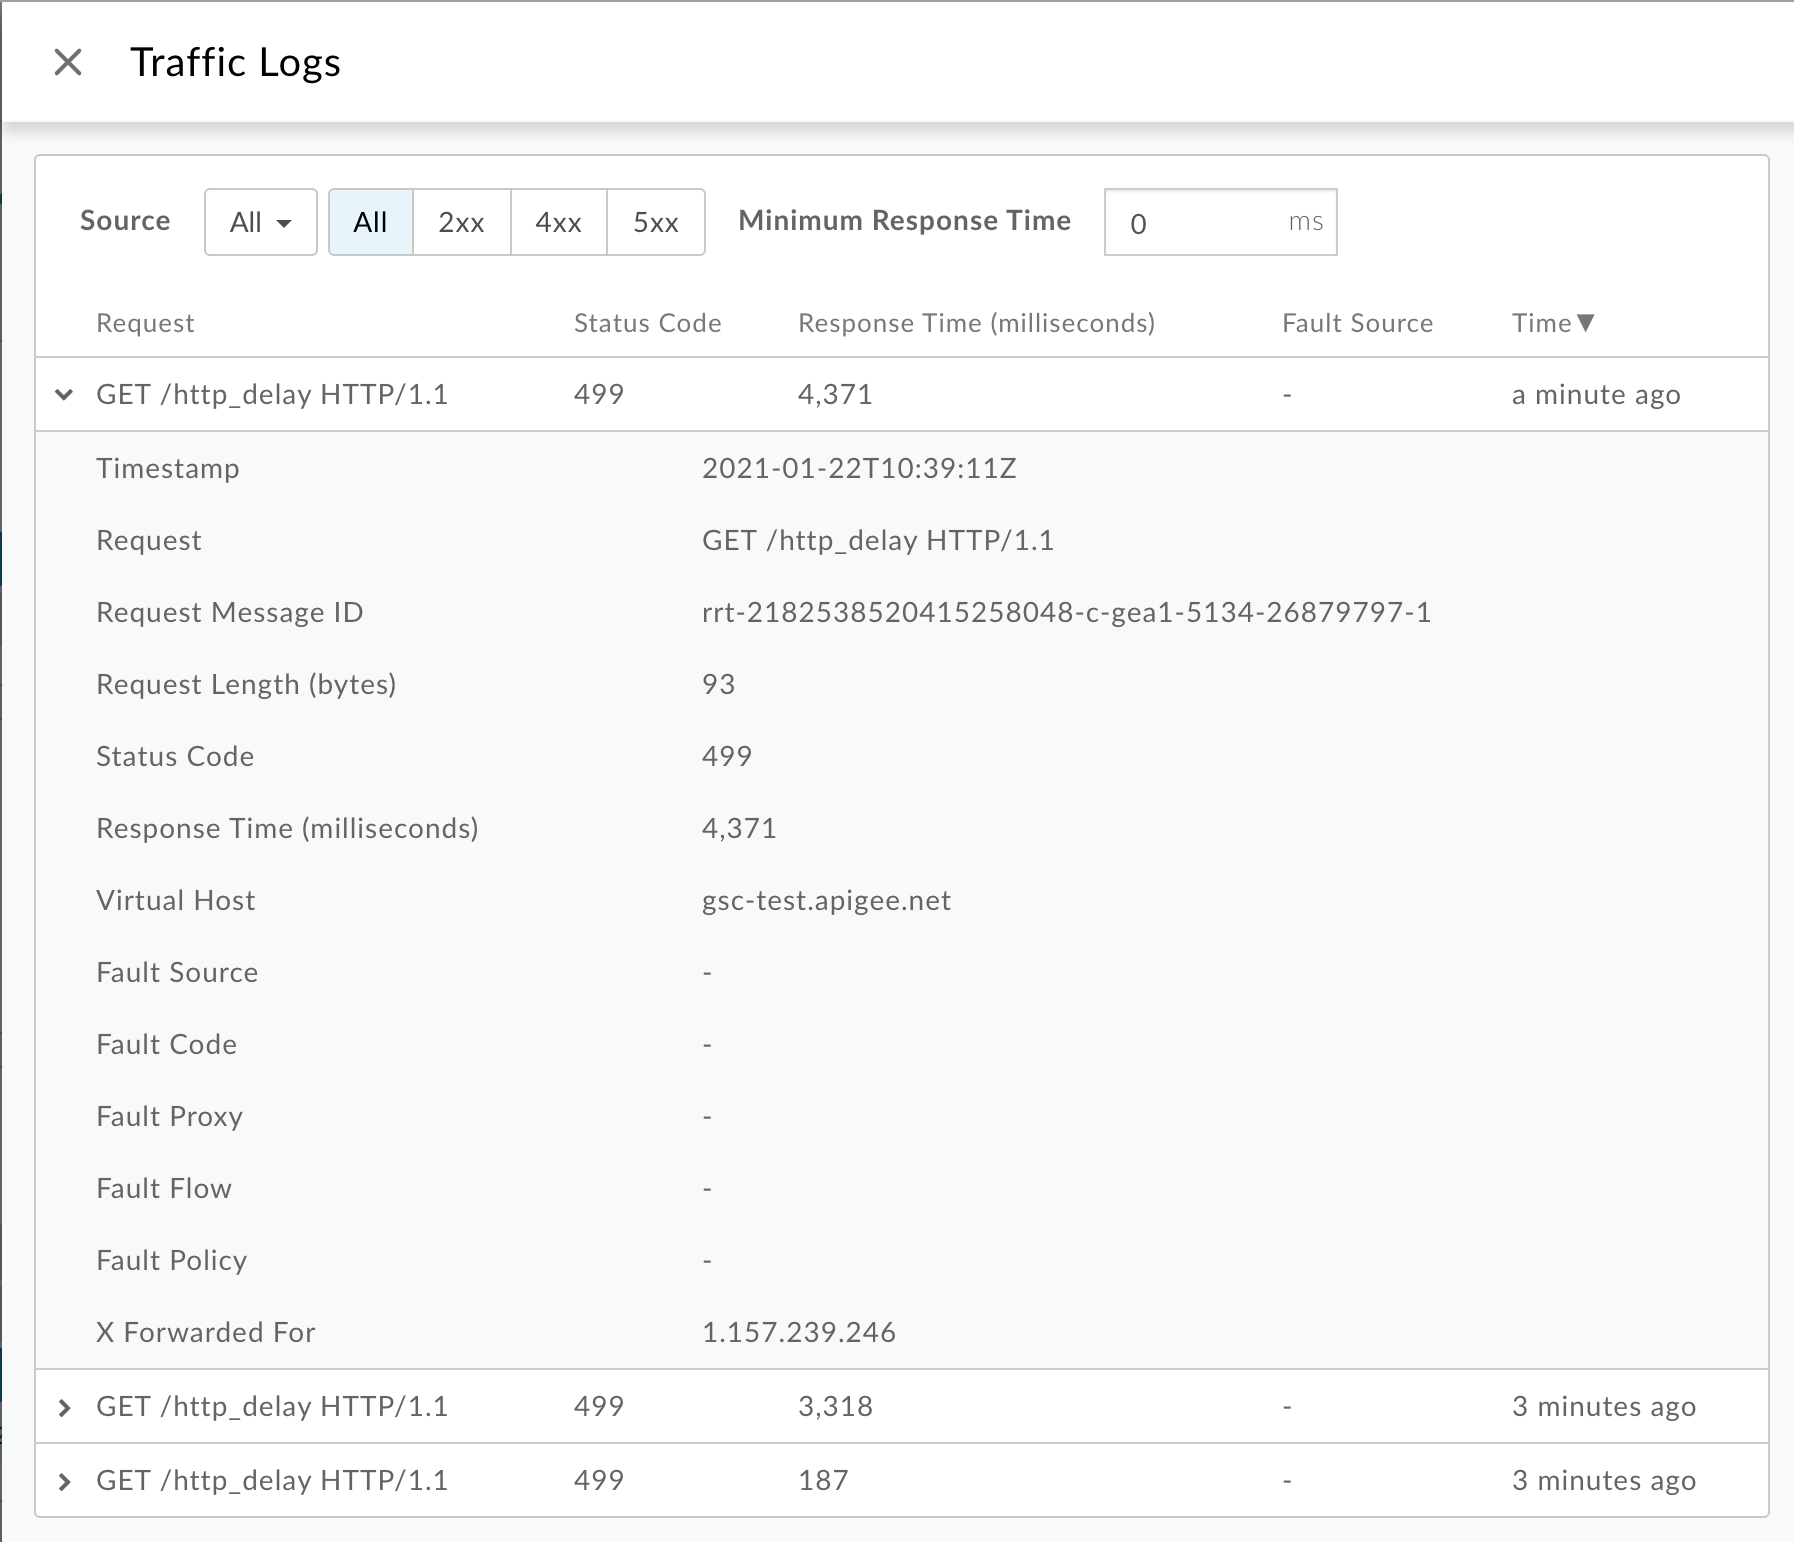
在流量日志窗口中,记下一些
499错误的以下详细信息:- 请求:提供用于进行调用的请求方法和 URI
- 响应 时间:此部分提供请求的总耗时。
您还可以使用 API 监控 GET logs API 获取所有日志。例如,通过查询
org、env、timeRange和status的日志,您将能够下载客户端超时交易的所有日志。由于 API 监控会将 HTTP
499错误的代理设置为-,因此您可以使用 API(Logs API)获取虚拟主机和路径的相关联代理。例如:
curl "https://apimonitoring.enterprise.apigee.com/logs/apiproxies?org=ORG&env=ENV&select=https://VIRTUAL_HOST/BASEBATH" -H "Authorization: Bearer $TOKEN"
- 查看响应时间,了解其他
499错误,并检查所有499错误的响应时间是否一致(例如 30 秒)。
NGINX 访问日志
如需使用 NGINX 访问日志诊断错误,请执行以下操作:
- 如果您是 Private Cloud 用户,则可以使用 NGINX 访问日志来确定有关 HTTP
499错误的关键信息。 - 检查 NGINX 访问日志:
/opt/apigee/var/log/edge-router/nginx/ORG~ENV.PORT#_access_log - 搜索以查看在特定时长内是否存在任何
499错误(如果问题发生在过去),或者是否仍有任何请求失败并显示499。 - 请注意以下有关部分
499错误的说明:- 总响应时间
- 请求 URI
- 用户代理
NGINX 访问日志中的 499 错误示例:
2019-08-23T06:50:07+00:00       rrt-03f69eb1091c4a886-c-sy      50.112.119.65:47756
10.10.53.154:8443       10.001  -       -       499     -       422     0
   GET /v1/products HTTP/1.1        -       okhttp/3.9.1    api.acme.org
rrt-03f69eb1091c4a886-c-sy-13001-6496714-1
    50.112.119.65   -       -       -       -       -       -       -       -1      -       -       dc-1  router-pod-1
rt-214-190301-0020137-latest-7d
36       TLSv1.2 gateway-1     dc-1  acme    prod  https   -
在此示例中,我们看到以下信息:
- 总响应时间:
10.001秒。这表示客户端在 10.001 秒后超时 - 请求:
GET /v1/products - 主机:
api.acme.org - 用户代理:
okhttp/3.9.1
- 检查所有
499错误中的总响应时间和用户代理是否一致。
原因:客户端突然关闭了连接
诊断
- 当从浏览器或移动应用中运行的单页应用调用 API 时,如果最终用户突然关闭浏览器、在同一标签页中前往其他网页,或者通过点击或点按 停止加载来停止加载网页,浏览器将中止该请求。
- 如果发生这种情况,HTTP 状态为
499的交易通常会在每个请求的请求处理时间(响应时间)方面有所不同。 -
您可以比较响应时间,并使用 API 监控或 NGINX 访问日志(如常见诊断步骤中所述)验证每种
499错误的响应时间是否不同,从而确定这是否是导致问题的原因。
分辨率
- 这是正常现象,如果 HTTP
499错误数量较少,通常不必担心。 -
如果同一网址路径经常出现这种情况,可能是因为与该路径关联的特定代理非常慢,用户不愿意等待。
了解哪些代理可能会受到影响后,请使用延迟分析信息中心进一步调查导致代理延迟的原因。
- 在这种情况下,请按照常见诊断步骤中的步骤确定受影响的代理。
- 使用 延迟时间分析信息中心进一步调查导致代理延迟的原因并解决问题。
- 如果您发现特定代理的延迟时间符合预期,则可能需要告知用户此代理需要一段时间才能做出响应。
原因:客户端应用超时
这种情况可能发生在多种情况下。
-
在正常运行条件下,预计请求需要一定的时间(假设为 10 秒)才能完成。但是,客户端应用设置了错误的超时值(假设为 5 秒),这会导致客户端应用在 API 请求完成之前超时,从而导致
499。在这种情况下,我们需要将客户端超时时间设置为适当的值。 - 目标服务器或调出所用的时间超出预期。在这种情况下,您需要修复相应组件,并适当调整超时值。
- 客户端不再需要响应,因此中止了连接。对于自动补全或短轮询等高频 API,可能会发生这种情况。
诊断
API Monitoring 或 NGINX 访问日志
使用 API 监控或 NGINX 访问日志诊断错误:
- 按照常见诊断步骤中的说明,检查 API Monitoring 日志或 NGINX 访问日志中是否存在 HTTP
499事务。 - 确定所有
499错误的响应时间是否一致。 - 如果可以,则可能是某个特定客户端应用在其端配置了固定超时时间。如果 API 代理或目标服务器响应缓慢,客户端会在代理超时之前超时,从而导致同一 URI 路径出现大量 HTTP
499s。在这种情况下,请从 NGINX 访问日志中确定 User Agent,这有助于您确定具体的客户端应用。 - Apigee 前面也可能有一个负载平衡器,例如 Akamai、F5、AWS ELB 等。如果 Apigee 在自定义负载平衡器后面运行,则必须将负载平衡器的请求超时时间配置为大于 Apigee API 超时时间。默认情况下,Apigee 路由器会在 57 秒后超时,因此适合在负载平衡器上配置 60 秒的请求超时时间。
跟踪记录
使用 Trace 诊断错误
如果问题仍然存在(仍出现 499 错误),请执行以下步骤:
- 在 Edge 界面中为受影响的 API 启用跟踪会话。
- 您可以等待错误发生,也可以在有 API 调用的情况下进行一些 API 调用,重现该错误。
- 检查每个阶段的耗时,并记下花费时间最多的阶段。
- 如果您在以下某个阶段之后立即发现耗时最长的错误,则表示后端服务器速度较慢或处理请求的时间较长:
- 已向目标服务器发送请求
- ServiceCallout 政策
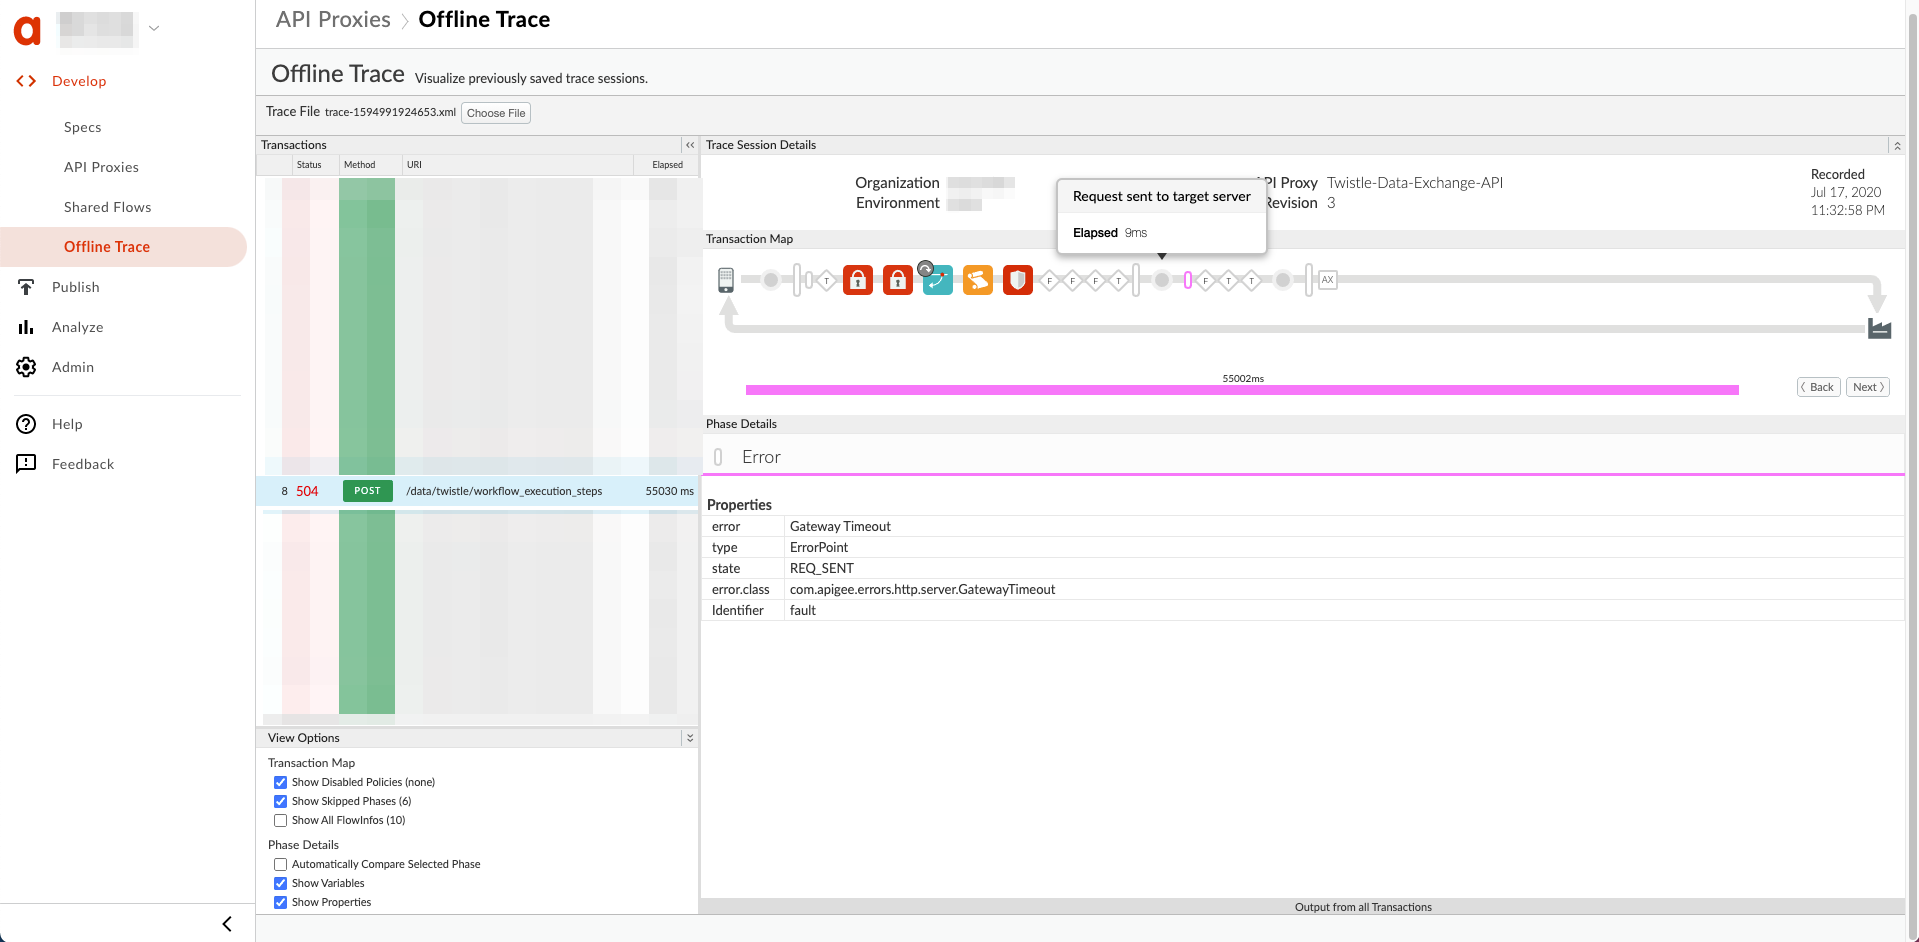
以下是一个界面轨迹示例,显示了向目标服务器发送请求后出现的网关超时:
分辨率
- 请参阅 配置 I/O 超时的最佳实践,了解应在通过 Apigee Edge 的 API 请求流程中涉及的不同组件上设置哪些超时值。
- 确保根据最佳实践在客户端应用上设置适当的超时值。
如果问题仍然存在,请前往必须收集诊断信息。
必须收集的诊断信息
如果问题仍然存在,请收集以下诊断信息,然后联系 Apigee Edge 支持团队。
如果您是公共云用户,请提供以下信息:
- 组织名称
- 环境名称
- API 代理名称
- 用于重现超时错误的完整
curl命令 - 您看到客户端超时错误的 API 请求的跟踪文件
如果您是私有云用户,请提供以下信息:
- 失败请求的完整错误消息
- 环境名称
- API 代理软件包
- 您看到客户端超时错误的 API 请求的跟踪文件
- NGINX 访问日志 (
/opt/apigee/var/log/edge-router/nginx/ORG~ENV.PORT#_access_log) - 消息处理器系统日志 (
/opt/apigee/var/log/edge-message-processor/logs/system.log)