

Vous consultez la documentation Apigee Edge.
Accédez à la
documentation**Apigee X**. info
Problème constaté
L'application cliente reçoit un code d'état de réponse HTTP 503 avec le message
Service Unavailable suite à un appel de proxy d'API.
Message d'erreur
L'application cliente reçoit le code de réponse suivant :
HTTP/1.1 503 Service Unavailable
Vous pouvez également observer le message d'erreur suivant :
{
   "fault": {
      "faultstring": "The Service is temporarily unavailable",
      "detail": {
           "errorcode": "messaging.adaptors.http.flow.ServiceUnavailable"
       }
    }
}
Causes possibles :
| Cause | Description | Instructions de dépannage applicables |
|---|---|---|
| Le serveur cible ferme prématurément la connexion | Le serveur cible met fin prématurément à la connexion alors que le processeur de messages envoie toujours la charge utile de la requête. | Utilisateurs du cloud public et privé Edge |
Étapes de diagnostic courantes
Déterminer l'ID de message de la requête en échec
Outil Trace
Pour déterminer l'ID de message de la requête en échec à l'aide de l'outil Trace :
- Si le problème est toujours actif, activez la session de trace pour l'API concernée.
- Effectuez l'appel d'API et reproduisez le problème :
503 Service Unavailableavec le code d'erreurmessaging.adaptors.http.flow.ServiceUnavailable. - Sélectionnez l'une des requêtes en échec.
- Accédez à la phase AX et déterminez l'ID de message
(
X-Apigee.Message-ID) de la requête en faisant défiler la section Détails de la phase, comme illustré dans la figure suivante.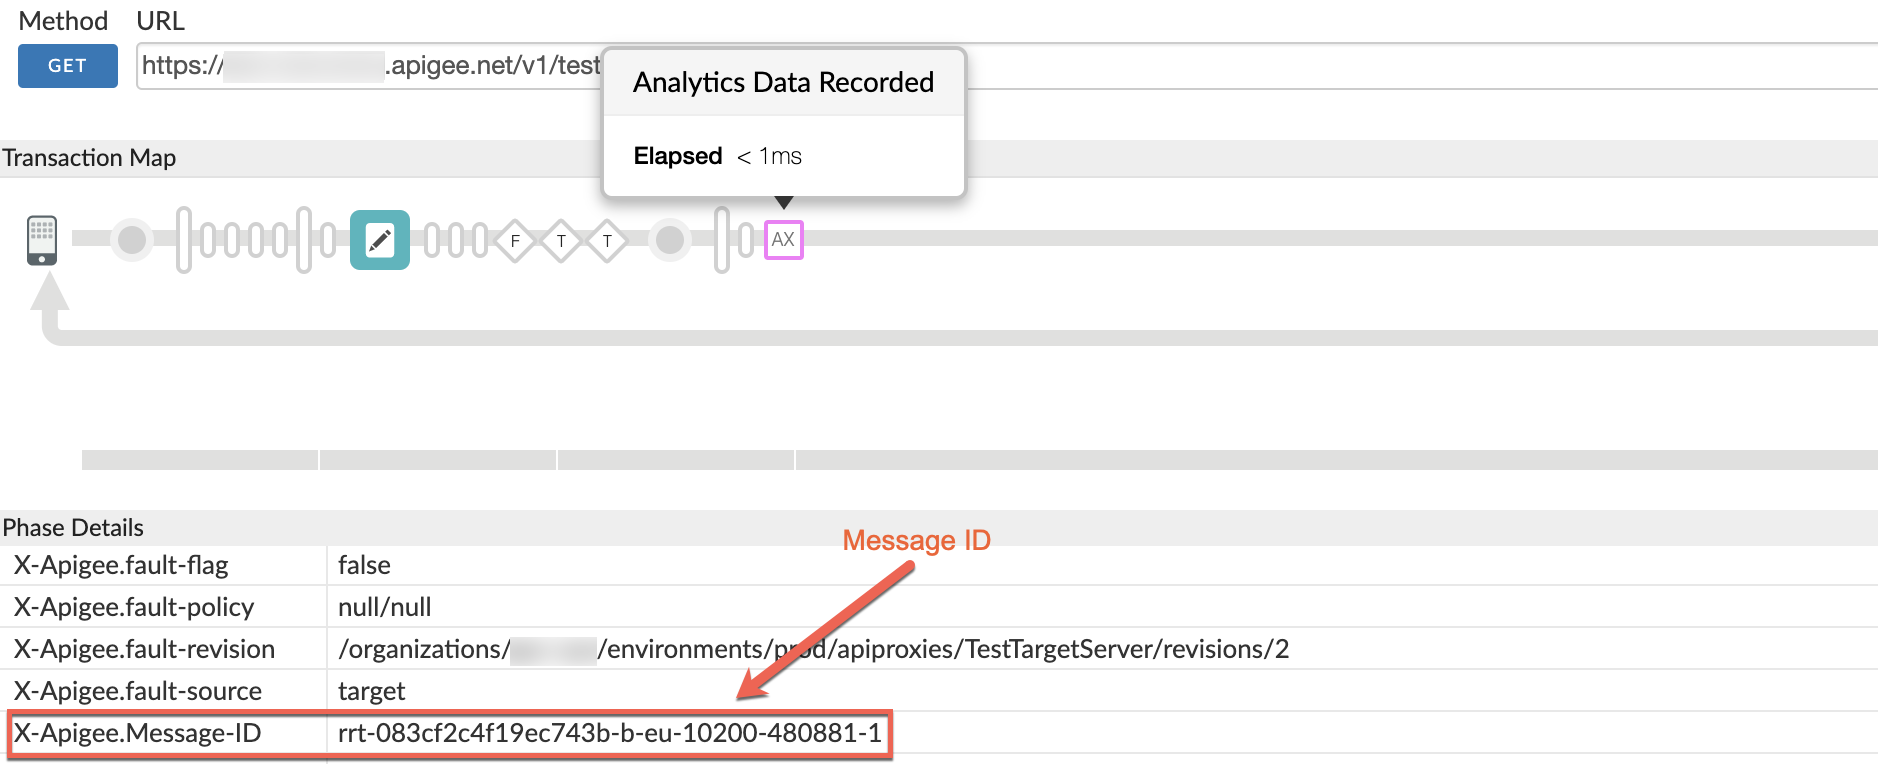
Journaux d'accès NGINX
Pour déterminer l'ID de message de la requête en échec à l'aide des journaux d'accès NGINX :
Vous pouvez également consulter les journaux d'accès NGINX pour déterminer l'ID de message des erreurs 503.
Ceci est particulièrement utile si le problème est survenu par le passé ou s'il est intermittent
et que vous ne parvenez pas à capturer la trace dans l'interface utilisateur. Procédez comme suit pour déterminer ces informations à partir des journaux d'accès NGINX :
- Consultez les journaux d'accès NGINX : (
/opt/apigee/var/log/edge-router/nginx/ORG~ENV.PORT#_access_log) - Recherchez les erreurs
503pour le proxy d'API spécifique pendant une durée spécifique (si le problème s'est produit par le passé) ou si des requêtes échouent toujours avec503. - S'il existe des erreurs
503avec X-Apigee-fault-code messaging.adaptors.http.flow.ServiceUnavailable, notez l'ID de message d'une ou plusieurs de ces requêtes, comme illustré dans l'exemple suivant :Exemple d'entrée affichant l'erreur
503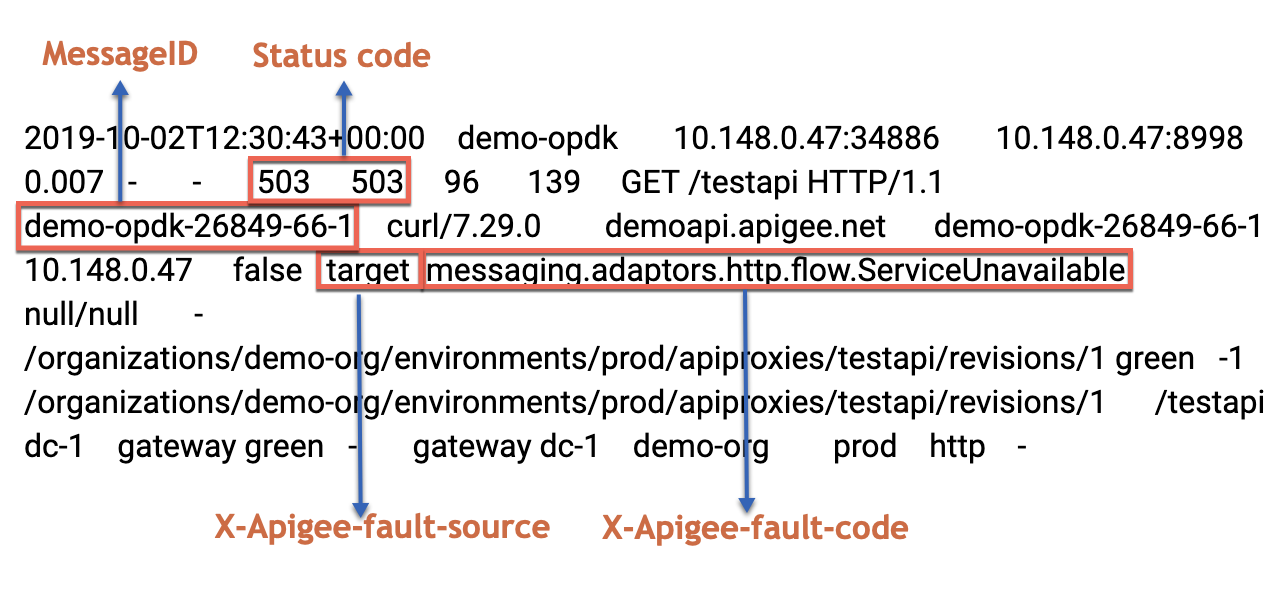
Cause : le serveur cible ferme prématurément la connexion
Diagnostic
- Si vous êtes un utilisateur du cloud public ou du cloud privé :
- Utilisez l'outil Trace (comme expliqué dans Étapes de diagnostic courantes)
et vérifiez que les deux éléments suivants sont définis dans le volet Données Analytics enregistrées :
- X-Apigee.fault-code:
messaging.adaptors.http.flow.ServiceUnavailable - X-Apigee.fault-source:
target
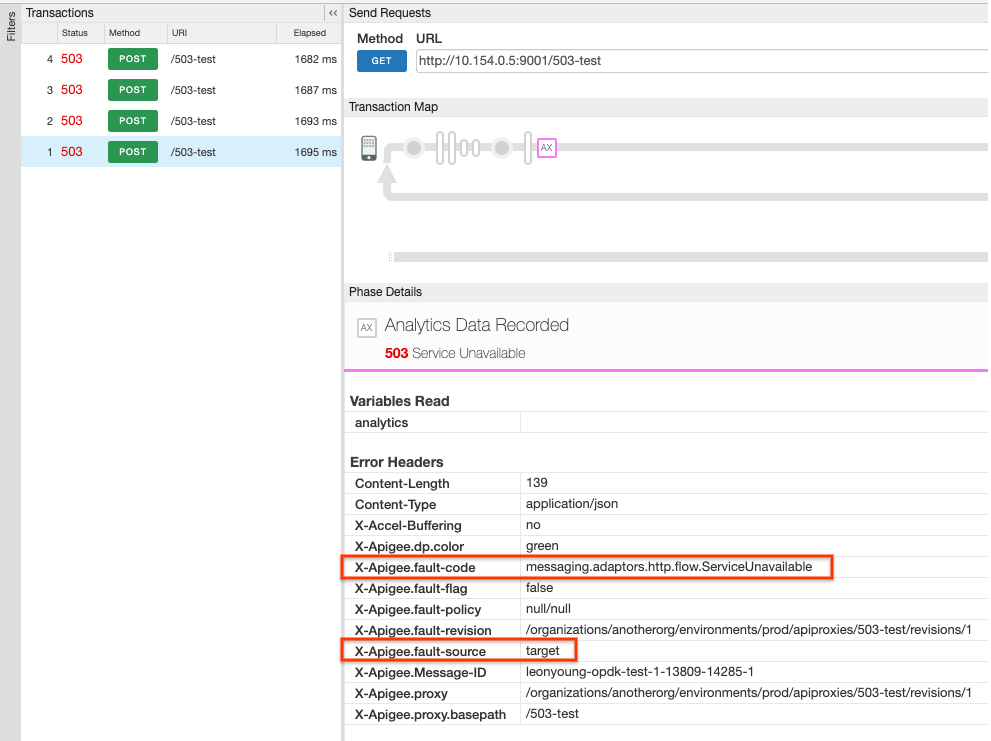
- X-Apigee.fault-code:
- Utilisez l'outil Trace (comme expliqué dans Étapes de diagnostic courantes)
et vérifiez que les deux éléments suivants sont définis dans le volet Erreur immédiatement après
la propriété
TARGET_REQ_FLOWstate :- error.class: :
com.apigee.errors.http.server.ServiceUnavailableException - error.cause: :
Broken pipe
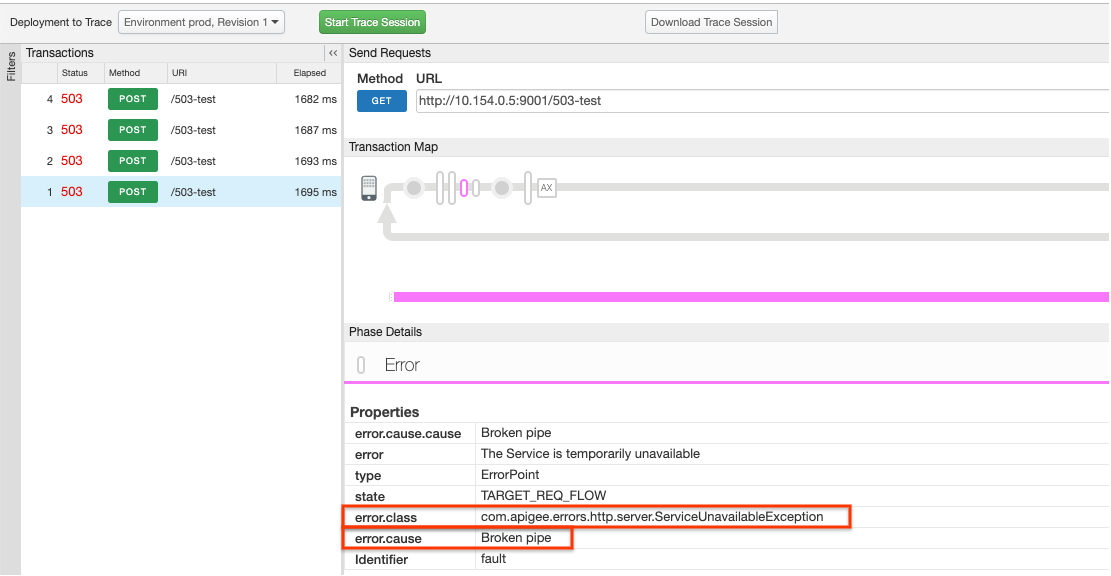
- error.class: :
- Accédez à Utiliser tcpdump pour une analyse plus approfondie.
- Utilisez l'outil Trace (comme expliqué dans Étapes de diagnostic courantes)
et vérifiez que les deux éléments suivants sont définis dans le volet Données Analytics enregistrées :
- Si vous êtes un utilisateur du cloud privé :
- Déterminez l'ID de message de la requête en échec.
- Recherchez l'ID de message dans le journal du processeur de messages
(
/opt/apigee/var/log/edge-message-processor/logs/system.log). - L'une des exceptions suivantes s'affiche :
Exception 1 : java.io.IOException: Broken pipe occurred while writing to channel ClientOutputChannel
2021-01-30 15:31:14,693 org:anotherorg env:prod api:myproxy
rev:1 messageid:myorg-opdk-test-1-30312-13747-1  NIOThread@1
INFO  HTTP.SERVICE - ExceptionHandler.handleException() :
Exception java.io.IOException: Broken pipe occurred while writing to channel
ClientOutputChannel(ClientChannel[Connected:
Remote:IP:PORT Local:0.0.0.0:42828]@8380 useCount=1
bytesRead=0 bytesWritten=76295 age=2012ms  lastIO=2ms  isOpen=false)
ou
Exception 2 : onExceptionWrite exception: {}
java.io.IOException: Broken pipe2021-01-31 15:29:37,438 org:anotherorg env:prod api:503-test rev:1 messageid:leonyoung-opdk-test-1-18604-13978-1 NIOThread@0 ERROR HTTP.CLIENT - HTTPClient$Context$2.onException() : ClientChannel[Connected: Remote:IP:PORT Local:0.0.0.0:57880]@8569 useCount=1 bytesRead=0 bytesWritten=76295 age=3180ms lastIO=2 ms isOpen=false.onExceptionWrite exception: {} java.io.IOException: Broken pipe
- Ces deux exceptions indiquent que, alors que le processeur de messages écrivait toujours la
charge utile de la requête sur le serveur backend, la connexion a été fermée prématurément par le
serveur backend. Par conséquent, le processeur de messages génère l'exception
java.io.IOException: Broken pipe. - L'élément
Remote:IP:PORTindique l'adresse IP et le numéro de port du serveur backend résolus. - L'attribut
bytesWritten=76295dans le message d'erreur ci-dessus indique que le processeur de messages avait envoyé une charge utile de76295octets au serveur backend lorsque la connexion a été fermée prématurément. - L'attribut
bytesRead=0indique que le processeur de messages n'a reçu aucune donnée (réponse) du serveur backend. - Pour examiner ce problème plus en détail, collectez un
tcpdumpsur le serveur backend ou le processeur de messages, puis analysez-le comme expliqué ci-dessous.
Utilisation de tcpdump
-
Capturez un
tcpdumpsur le serveur backend ou le processeur de messages à l'aide des commandes suivantes :Commande permettant de collecter
tcpdumpsur le serveur backend :tcpdump -i any -s 0 host MP_IP_ADDRESS -w FILE_NAME
Commande permettant de collecter
tcpdumpsur le processeur de messages :tcpdump -i any -s 0 host BACKEND_HOSTNAME -w FILE_NAME
- Analysez le
tcpdumpcapturé :Exemple de résultat tcpdump (collecté sur le processeur de messages) :
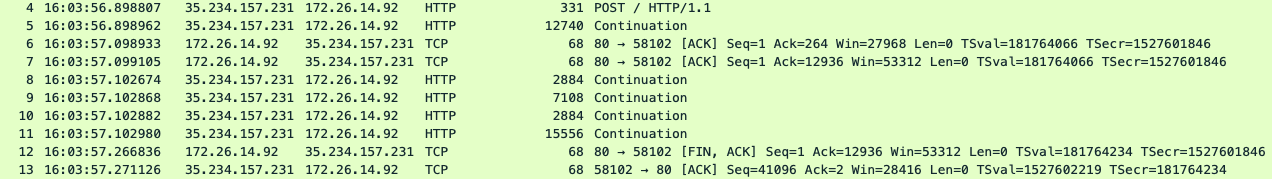
Dans le
tcpdumpci-dessus, vous pouvez voir les éléments suivants :- Dans le paquet
4, le processeur de messages a envoyé une requêtePOSTau serveur backend. - Dans les paquets
5,8,9,10,11le processeur de messages a continué à envoyer la charge utile de la requête au serveur backend. - Dans les paquets
6et7,le serveur backend a répondu avecACKpour une partie de la charge utile de la requête reçue du processeur de messages. - Toutefois, dans le paquet
12, au lieu de répondre avec unACKpour les paquets de données d'application reçus, puis avec la charge utile de réponse , le serveur backend répond avec unFIN ACKqui lance la fermeture de la connexion. - Cela montre clairement que le serveur backend ferme la connexion prématurément alors que le processeur de messages envoyait toujours la charge utile de la requête.
- Le processeur de messages enregistre alors une
IOException: Broken Pipeerreur et renvoie un503au client.
- Dans le paquet
Solution
- Collaborez avec votre équipe d'application et/ou votre équipe réseau pour analyser et résoudre le problème lié aux déconnexions prématurées côté serveur backend.
- Assurez-vous que l'application du serveur backend n'expire pas et ne réinitialise pas la connexion avant de recevoir l'intégralité de la charge utile de la requête.
- Si vous disposez d'un appareil ou d'une couche réseau intermédiaire entre Apigee et le serveur backend, assurez-vous qu'ils n'expirent pas avant la réception de l'intégralité de la charge utile de la requête.
Si le problème persiste, consultez la page Vous devez collecter des informations de diagnostic.
Vous devez collecter des informations de diagnostic
Si le problème persiste, même après avoir suivi les instructions ci-dessus, rassemblez les informations de diagnostic suivantes, puis contactez l'assistance Apigee Edge :
Si vous êtes un utilisateur du cloud public, fournissez les informations suivantes :
- Nom de l'organisation
- Nom de l'environnement
- Nom de proxy d'API
- Commande
curlcomplète pour reproduire l'erreur503 - Fichier de trace contenant la requête avec l'erreur
503 Service Unavailable - Si les erreurs
503ne se produisent pas actuellement, indiquez la période avec les informations de fuseau horaire au cours de laquelle les erreurs503se sont produites par le passé.
Si vous êtes un utilisateur du cloud privé, fournissez les informations suivantes :
- Message d'erreur complet observé pour les requêtes en échec
- Nom de l'organisation, de l'environnement et du proxy d'API pour lesquels vous observez
503erreurs - Bundle de proxy d'API
- Fichier de trace contenant les requêtes avec l'erreur
503 Service Unavailable - Journaux d'accès NGINX
/opt/apigee/var/log/edge-router/nginx/ORG~ENV.PORT#_access_log - Journaux du processeur de messages
/opt/apigee/var/log/edge-message-processor/logs/system.log - Période avec les informations de fuseau horaire au cours de laquelle les erreurs
503se sont produites Tcpdumpscollectés sur les processeurs de messages et le serveur backend lorsque l' erreur s'est produite