

אתם צופים במסמכי התיעוד של Apigee Edge.
כדאי לעיין במסמכי התיעוד של Apigee X. מידע
תיאור הבעיה
אפליקציית הלקוח מקבלת שגיאת זמן קצוב (timeout) לבקשות API, או שהבקשה מסתיימת באופן פתאומי בזמן שהבקשה ל-API עדיין מבוצעת ב-Apigee.
במעקב אחר API וב-NGINX Access logs, קוד הסטטוס של בקשות API כאלה יהיה 499. לפעמים מוצגים קודי סטטוס שונים ב-API Analytics כי הוא מציג את קוד הסטטוס שמוחזר על ידי מעבד ההודעות.
הודעת שגיאה
יכול להיות שיוצגו שגיאות באפליקציות לקוח, כמו:
curl: (28) Operation timed out after 6001 milliseconds with 0 out of -1 bytes received
מה גורם לזמני קצובים לתפוגה בלקוח?
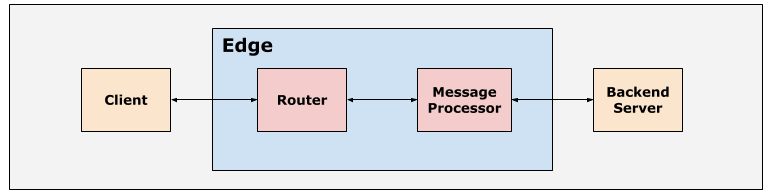
הנתיב הרגיל של בקשת API בפלטפורמת Edge הוא Client > Router > Message Processor > Backend Server, כמו שמוצג באיור הבא:
נתוני הזמן הקצוב לתפוגה שמוגדרים בנתבים ובמעבדי ההודעות בפלטפורמת Apigee Edge הם נתוני ברירת מחדל מתאימים, כדי להבטיח שייקח זמן קצר ככל האפשר להשלמת בקשות ה-API.
זמן קצוב לתפוגה בלקוח
אפשר להגדיר באפליקציות לקוח ערך מתאים של זמן קצוב לתפוגה בהתאם לצרכים שלכם.
ללקוחות כמו דפדפני אינטרנט ואפליקציות לנייד יש פסק זמן שמוגדר על ידי מערכת ההפעלה.
פסק זמן בנתב
הזמן הקצוב לתפוגה שמוגדר כברירת מחדל בנתבים הוא 57 שניות. זהו משך הזמן המקסימלי שבו proxy ל-API יכול לפעול מרגע קבלת בקשת ה-API ב-Edge ועד שליחת התגובה בחזרה, כולל התגובה של ה-Backend וכל כללי המדיניות שמופעלים. אפשר לבטל את הגדרת ברירת המחדל של הזמן הקצוב לתפוגה בנתבים ובמארחים וירטואליים, כמו שמוסבר במאמר הגדרת זמן קצוב לתפוגה של קלט/פלט בנתבים.
זמן קצוב לתפוגה במעבדי בקשות
הזמן הקצוב לתפוגה שמוגדר כברירת מחדל במעבדי הודעות הוא 55 שניות. זהו משך הזמן המקסימלי ששרת הקצה העורפי יכול להקדיש לעיבוד הבקשה ולשליחת תגובה חזרה ל-Message Processor. אפשר לשנות את הגדרת ברירת המחדל של הזמן הקצוב לתפוגה במעבדי ההודעות או ב-API Proxy, כמו שמוסבר במאמר בנושא הגדרת זמן קצוב לתפוגה של קלט/פלט במעבדי הודעות.
אם הלקוח סוגר את החיבור לנתב לפני שחלף הזמן הקצוב לשרת ה-proxy של ה-API, תופיע שגיאת הזמן הקצוב לבקשת ה-API הספציפית. קוד הסטטוס 499 Client
Closed Connection מתועד בנתב עבור בקשות כאלה, ואפשר לראות אותו ביומני הגישה של API Monitoring ו-NGINX.
סיבות אפשריות
ב-Edge, הסיבות האופייניות לשגיאה 499 Client Closed Connection הן:
| סיבה | תיאור | הוראות לפתרון בעיות שרלוונטיות ל |
|---|---|---|
| הלקוח סגר את החיבור באופן פתאומי | זה קורה כשהלקוח סוגר את החיבור בגלל שמשתמש הקצה ביטל את הבקשה לפני שהיא הושלמה. | משתמשים בענן ציבורי ובענן פרטי |
| זמן קצוב לתפוגה של אפליקציית לקוח | זה קורה כשזמן ההמתנה של אפליקציית הלקוח מסתיים לפני ש-API Proxy מספיק לעבד ולשלוח את התשובה. בדרך כלל זה קורה כשזמן הקצוב לתפוגה של הלקוח קצר יותר מזמן הקצוב לתפוגה של הנתב. | משתמשים בענן ציבורי ובענן פרטי |
שלבים נפוצים לאבחון
כדי לאבחן את השגיאה הזו, אפשר להשתמש באחד מהכלים או מהטכניקות הבאים:
- API Monitoring
- יומני גישה של NGINX
API Monitoring
כדי לאבחן את השגיאה באמצעות הכלי 'מעקב אחר API':
- עוברים לדף Analyze > API Monitoring > Investigate.
- מסננים לפי
4xxשגיאות ובוחרים את מסגרת הזמן. - משרטטים את קוד הסטטוס מול הזמן.
- בוחרים תא עם
499שגיאות כמו שמוצג למטה: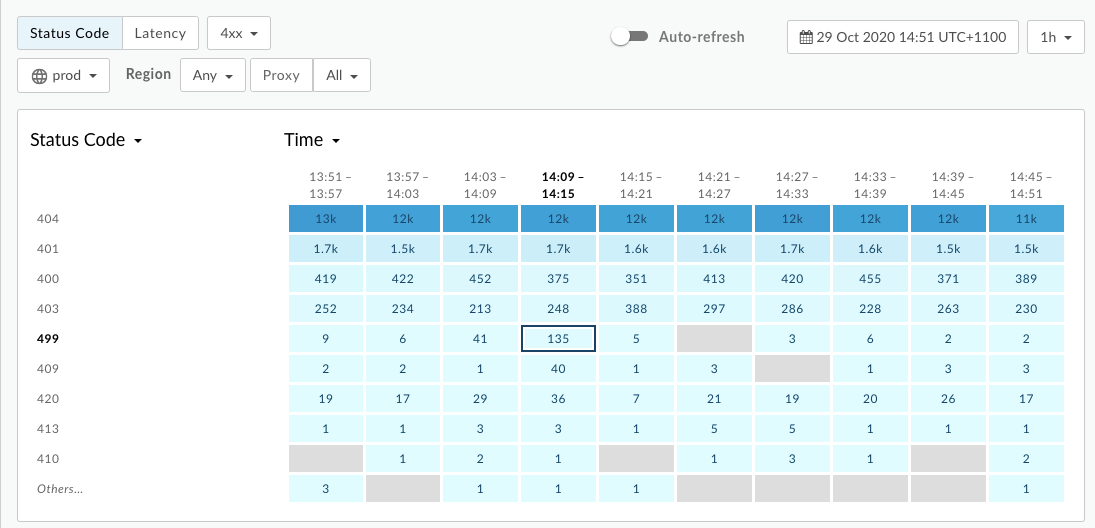
- בצד שמאל של המסך יופיע המידע על השגיאה
499, כמו שמוצג למטה: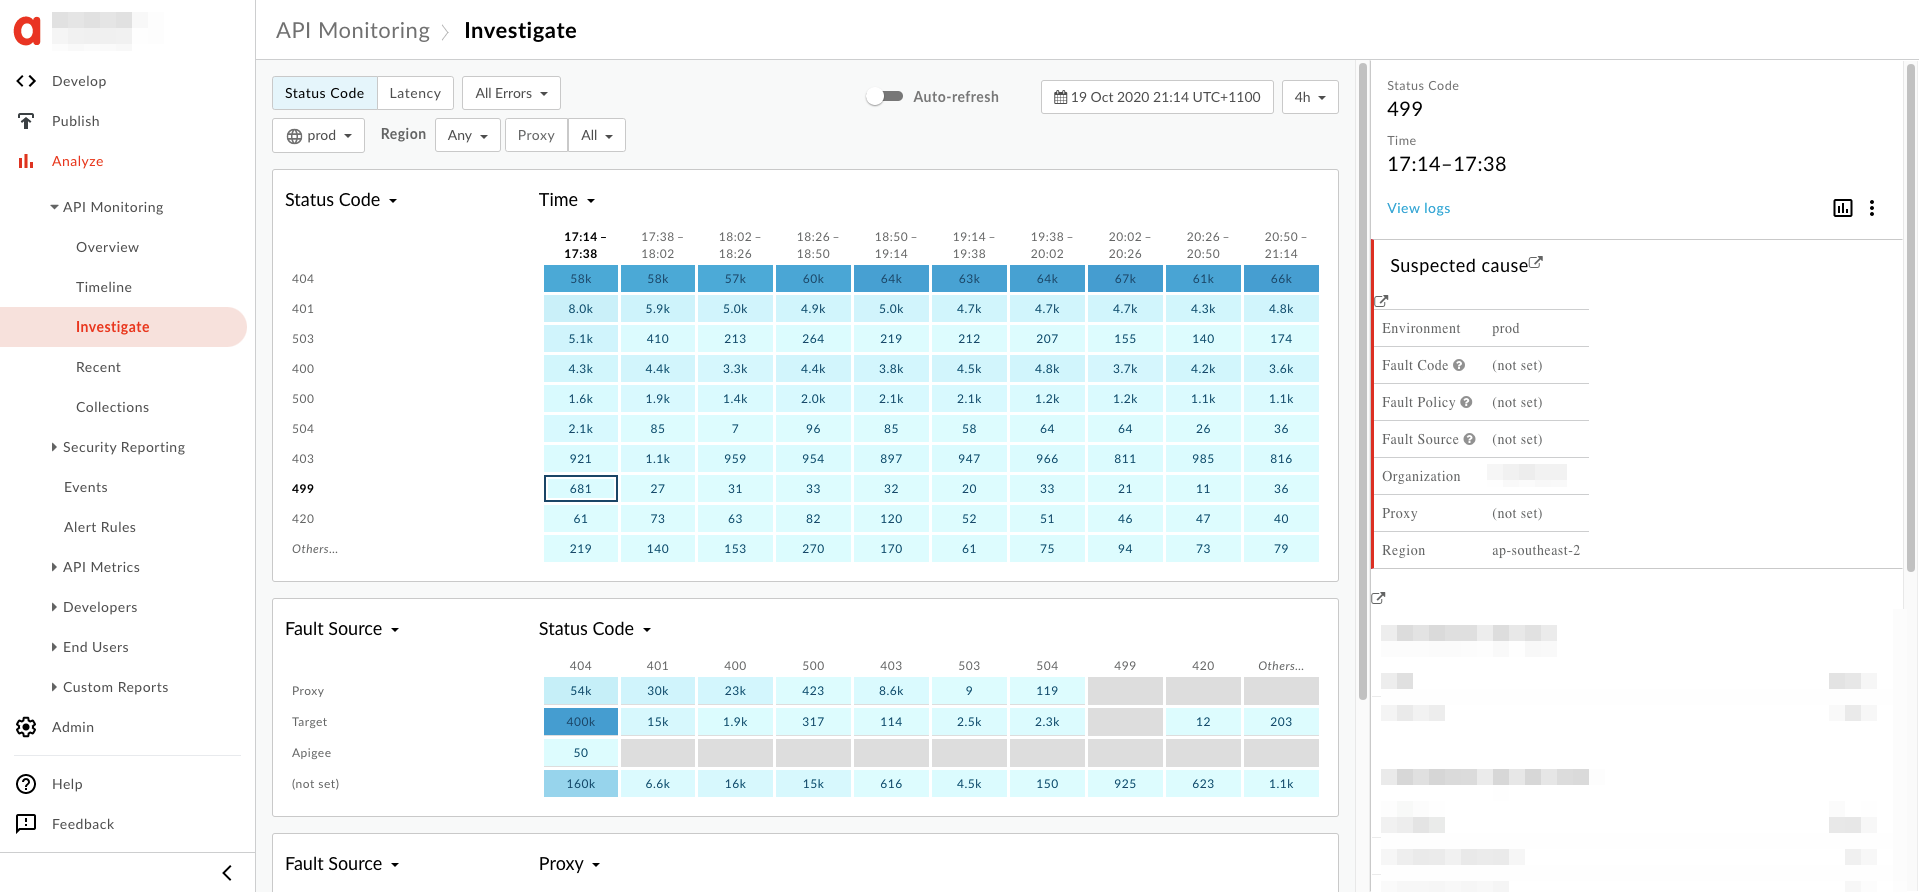
- בחלונית השמאלית, לוחצים על הצגת יומנים.
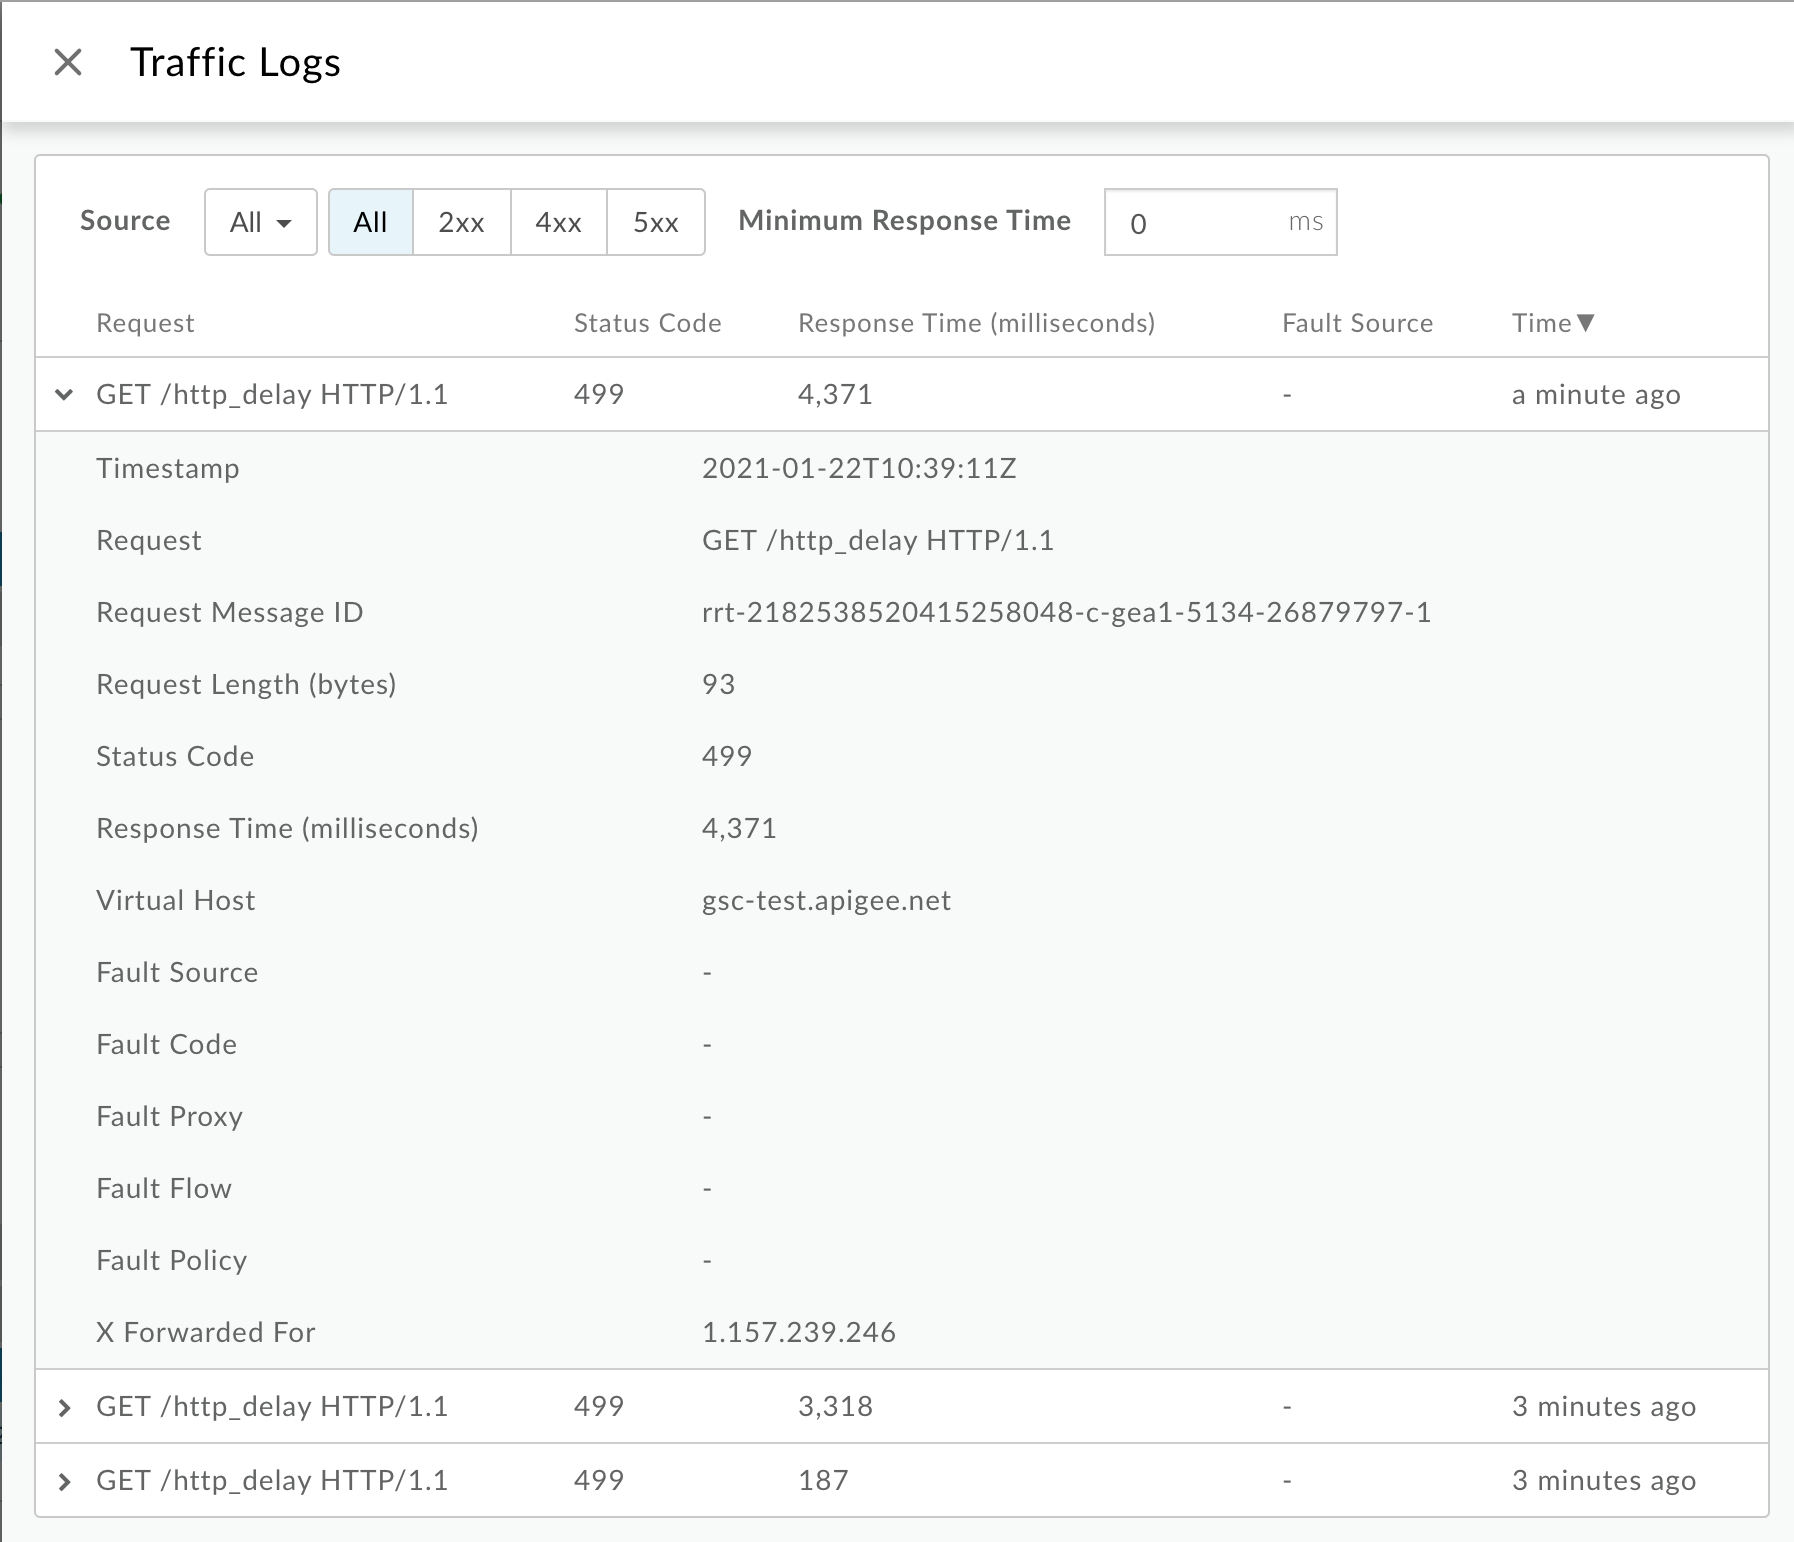
בחלון Traffic Logs (יומני תנועה), שימו לב לפרטים הבאים לגבי חלק מהשגיאות
499:- בקשה:כאן מוצגים שיטת הבקשה ומזהה ה-URI ששימשו ליצירת השיחות
- זמן התגובה:משך הזמן הכולל שחלף מאז הבקשה.
אפשר גם לקבל את כל היומנים באמצעות API Monitoring GET logs API. לדוגמה, אם תריצו שאילתה ביומנים של
org, env, timeRangeו-status, תוכלו להוריד את כל היומנים של טרנזקציות שבהן חלף הזמן הקצוב לתגובה של הלקוח.מכיוון ש-API Monitoring מגדיר את ה-proxy ל-
-לשגיאות HTTP499, אפשר להשתמש ב-API (Logs API) כדי לקבל את ה-proxy המשויך למארח ולנתיב הווירטואליים.לדוגמה :
curl "https://apimonitoring.enterprise.apigee.com/logs/apiproxies?org=ORG&env=ENV&select=https://VIRTUAL_HOST/BASEBATH" -H "Authorization: Bearer $TOKEN"
- בודקים את זמן התגובה כדי לראות אם יש עוד שגיאות
499, ומוודאים שזמן התגובה עקבי (למשל 30 שניות) בכל השגיאות499.
יומני גישה של NGINX
כדי לאבחן את השגיאה באמצעות יומני הגישה של NGINX:
- אם אתם משתמשים ב-Private Cloud, אתם יכולים להשתמש ביומני הגישה של NGINX כדי לקבוע את פרטי המפתח לגבי שגיאות HTTP
499. - בודקים את יומני הגישה של NGINX:
/opt/apigee/var/log/edge-router/nginx/ORG~ENV.PORT#_access_log - מחפשים כדי לראות אם יש
499שגיאות במהלך תקופה מסוימת (אם הבעיה קרתה בעבר) או אם יש בקשות שעדיין נכשלות עם499. - הערה: הנה מידע על חלק מהשגיאות מסוג
499:- זמן התגובה הכולל
- URI של בקשה
- סוכן משתמש
דוגמה לשגיאה 499 מיומן הגישה של NGINX:
2019-08-23T06:50:07+00:00       rrt-03f69eb1091c4a886-c-sy      50.112.119.65:47756
10.10.53.154:8443       10.001  -       -       499     -       422     0
   GET /v1/products HTTP/1.1        -       okhttp/3.9.1    api.acme.org
rrt-03f69eb1091c4a886-c-sy-13001-6496714-1
    50.112.119.65   -       -       -       -       -       -       -       -1      -       -       dc-1  router-pod-1
rt-214-190301-0020137-latest-7d
36       TLSv1.2 gateway-1     dc-1  acme    prod  https   -
בדוגמה הזו, אנחנו רואים את המידע הבא:
- זמן התגובה הכולל:
10.001שניות. המשמעות היא שחלף הזמן הקצוב לתגובה של הלקוח אחרי 10.001 שניות - בקשה:
GET /v1/products - מארח:
api.acme.org - סוכן משתמש:
okhttp/3.9.1
- בודקים אם הערכים של זמן התגובה הכולל וסוכן המשתמש עקביים בכל השגיאות מסוג
499.
הסיבה: הלקוח סגר את החיבור באופן פתאומי
אבחון
- כשמתבצעת קריאה ל-API מאפליקציית דף יחיד שפועלת בדפדפן או באפליקציה לנייד, הדפדפן יבטל את הבקשה אם משתמש הקצה סוגר את הדפדפן באופן פתאומי, עובר לדף אינטרנט אחר באותה כרטיסייה או מפסיק את טעינת הדף בלחיצה או בהקשה על הפסקת הטעינה.
- במקרה כזה, בדרך כלל יהיה הבדל בין זמני העיבוד של הבקשות (זמן התגובה) של העסקאות עם סטטוס HTTP
499. -
כדי לבדוק אם זו הסיבה, משווים את זמן התגובה ומוודאים אם הוא שונה עבור כל אחת משגיאות
499באמצעות מעקב אחר API או יומני גישה של NGINX, כמו שמוסבר בשלבים נפוצים לאבחון.
רזולוציה
- זה מצב תקין, ובדרך כלל אין סיבה לדאגה אם
499השגיאות של HTTP מתרחשות בכמויות קטנות. -
אם זה קורה לעיתים קרובות באותו נתיב כתובת ה-URL, יכול להיות שהסיבה לכך היא ששרת ה-proxy הספציפי שמשויך לנתיב הזה איטי מאוד והמשתמשים לא מוכנים לחכות.
אחרי שמגלים איזה שרת proxy עשוי להיות מושפע, אפשר להשתמש בלוח הבקרה לניתוח זמן האחזור כדי לבדוק לעומק מה גורם לזמן האחזור של ה-proxy.
- במקרה כזה, צריך לקבוע איזה שרת proxy מושפע באמצעות השלבים שמפורטים במאמר שלבים נפוצים לאבחון.
- כדי להמשיך לבדוק מה גורם לזמן האחזור של ה-proxy ולפתור את הבעיה, אפשר להשתמש ב לוח הבקרה לניתוח זמן האחזור.
- אם אתם מגלים שההשהיה צפויה עבור ה-Proxy הספציפי, יכול להיות שתצטרכו להודיע למשתמשים שלכם שייקח זמן עד שה-Proxy יגיב.
הסיבה: פסק זמן באפליקציית הלקוח
הבעיה הזו יכולה להתרחש במספר תרחישים.
-
הבקשה צפויה להימשך זמן מסוים (נניח 10 שניות) עד להשלמתה בתנאי הפעלה רגילים. עם זאת, באפליקציית הלקוח מוגדר ערך זמן קצוב (timeout) שגוי (נניח 5 שניות), ולכן האפליקציה מגיעה למצב timeout לפני שהבקשה ל-API מסתיימת, מה שמוביל לשגיאה
499. במקרה כזה, צריך להגדיר את פסק הזמן של הלקוח לערך מתאים. - השרת או ה-callout של היעד נמשכים יותר זמן מהצפוי. במקרה כזה, צריך לתקן את הרכיב המתאים ולהתאים את ערכי הזמן הקצוב לתפוגה.
- הלקוח לא היה צריך יותר את התשובה ולכן ביטל את הפעולה. זה יכול לקרות בממשקי API בתדירות גבוהה, כמו השלמה אוטומטית או בדיקה קצרה.
אבחון
API Monitoring או יומני גישה של NGINX
אפשר לאבחן את השגיאה באמצעות API Monitoring או יומני גישה של NGINX:
- כדאי לבדוק את יומני הרישום של API Monitoring או את יומני הגישה של NGINX כדי לראות את העסקאות ב-HTTP
499, כמו שמוסבר במאמר בנושא שלבים נפוצים לאבחון. - בודקים אם זמן התגובה עקבי בכל השגיאות מסוג
499. - אם כן, יכול להיות שאפליקציית לקוח מסוימת הגדירה פסק זמן קבוע בצד שלה. אם שרת יעד או שרת proxy של API מגיבים לאט, הזמן הקצוב לתפוגה של הלקוח יסתיים לפני הזמן הקצוב לתפוגה של ה-proxy, וכתוצאה מכך יתקבלו כמויות גדולות של שגיאות HTTP
499sעבור אותו נתיב URI. במקרה כזה, צריך לקבוע את סוכן המשתמש מיומני הגישה של NGINX, שיכול לעזור לכם לקבוע את אפליקציית הלקוח הספציפית. - יכול להיות גם שיש מאזן עומסים לפני Apigee, כמו Akamai, F5, AWS ELB וכו'. אם Apigee פועל מאחורי מאזן עומסים בהתאמה אישית, צריך להגדיר את הזמן הקצוב לתפוגה של הבקשה במאזן העומסים כך שיהיה ארוך יותר מהזמן הקצוב לתפוגה של ה-API של Apigee. כברירת מחדל, הזמן הקצוב לתפוגה של Apigee Router הוא 57 שניות, ולכן מתאים להגדיר זמן קצוב לתפוגה של בקשה של 60 שניות במאזן העומסים.
מעקב
אבחון השגיאה באמצעות Trace
אם הבעיה עדיין פעילה (שגיאות 499 עדיין מתרחשות), מבצעים את השלבים הבאים:
- מפעילים את trace session עבור ה-API המושפע בממשק המשתמש של Edge.
- אפשר לחכות שהשגיאה תתרחש, או שאם יש לכם את הקריאה ל-API, תוכלו לבצע כמה קריאות ל-API ולשחזר את השגיאה.
- בודקים את הזמן שחלף בכל שלב ורושמים את השלב שבו חלף רוב הזמן.
- אם השגיאה עם הזמן שחלף הכי ארוך מופיעה מיד אחרי אחד מהשלבים הבאים, זה מצביע על כך שהשרת העורפי איטי או שלוקח לו הרבה זמן לעבד את הבקשה:
- הבקשה נשלחה לשרת היעד
- ServiceCallout policy
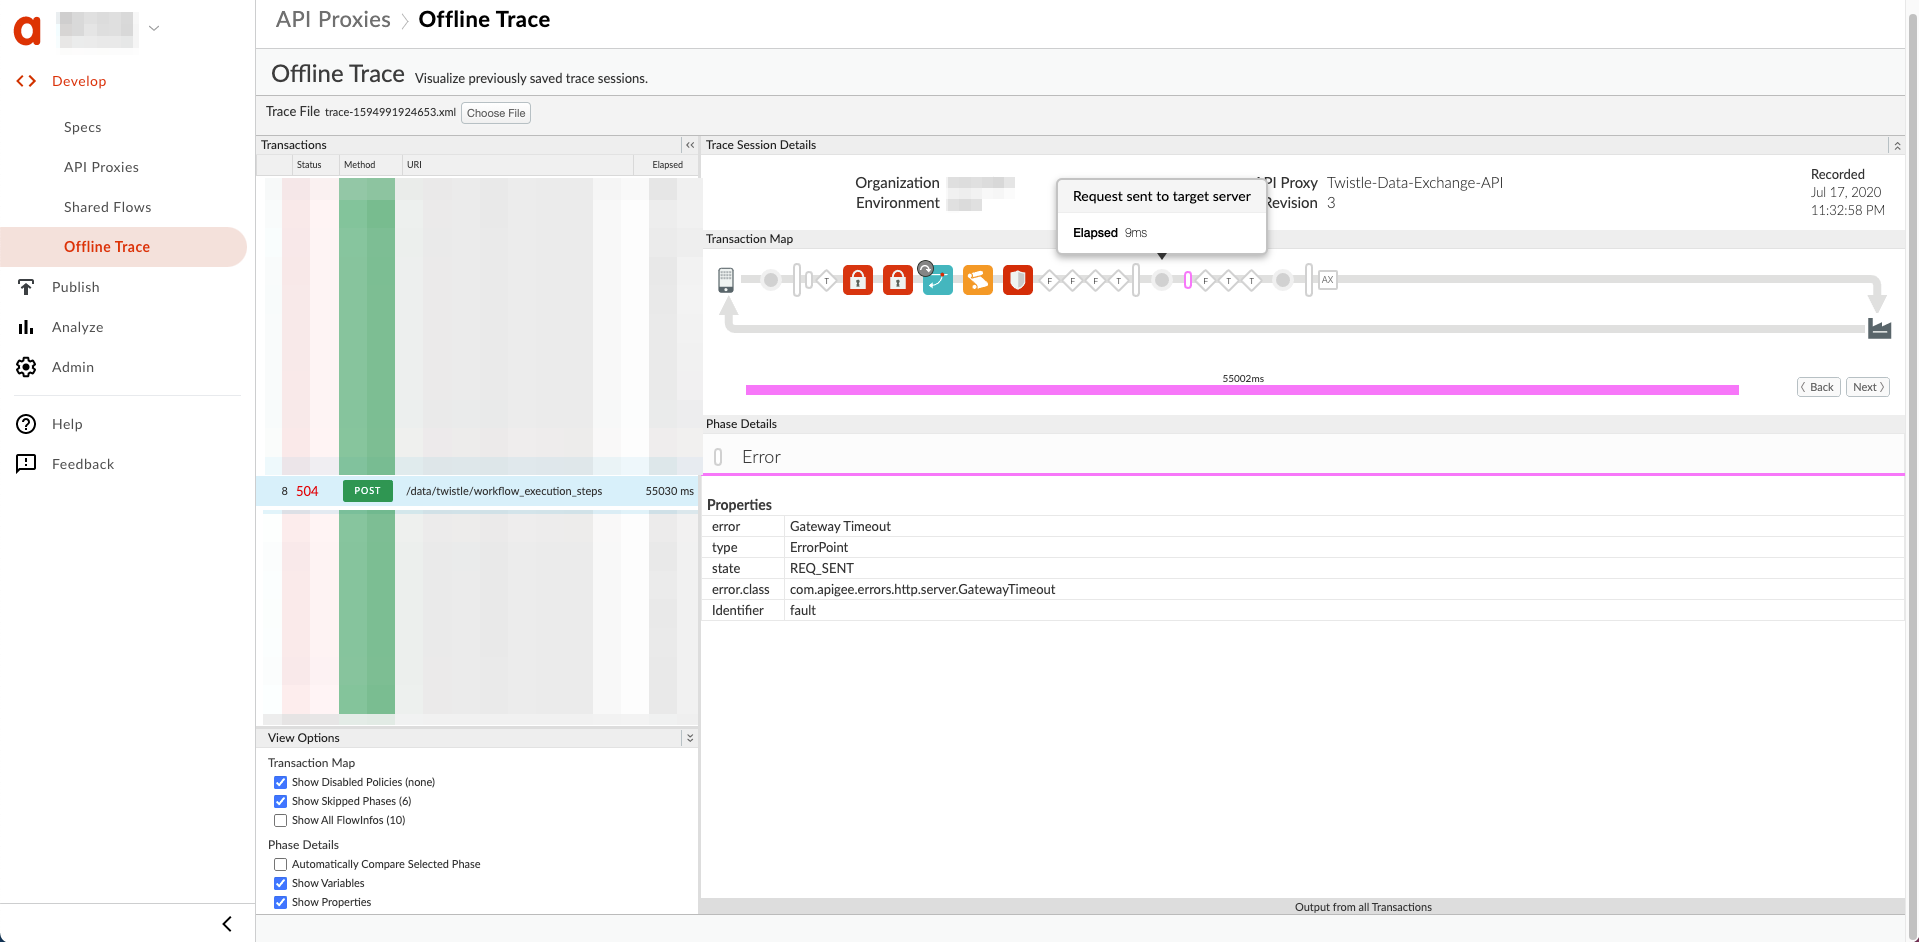
בדוגמה הבאה מוצג מעקב אחר ממשק משתמש עם Gateway Timeout אחרי שRequest נשלח לשרת היעד:
רזולוציה
- כדי להבין אילו ערכים של זמן קצוב לתפוגה צריך להגדיר ברכיבים שונים שמעורבים בתהליך של בקשת API דרך Apigee Edge, אפשר לעיין במאמר שיטות מומלצות להגדרת זמן קצוב לתפוגה של קלט/פלט.
- חשוב להגדיר ערך מתאים של זמן קצוב לתפוגה באפליקציית הלקוח בהתאם לשיטות המומלצות.
אם הבעיה נמשכת, אפשר לעבור אל איסוף מידע לצורך אבחון .
צריך לאסוף פרטי אבחון
אם הבעיה נמשכת, אוספים את פרטי האבחון הבאים ופונים אל התמיכה של Apigee Edge.
אם אתם משתמשים ב-Public Cloud, עליכם לספק את הפרטים הבאים:
- שם הארגון
- שם הסביבה
- שם ה-proxy ל-API
- פקודת
curlמלאה שבה השתמשת כדי לשחזר את שגיאת הזמן הקצוב לתפוגה - קובץ מעקב של בקשות ה-API שמוצגות לגביהן שגיאות של פסק זמן בלקוח
אם אתם משתמשים ב-Private Cloud, עליכם לספק את הפרטים הבאים:
- הודעת השגיאה המלאה שזוהתה בבקשות שנכשלו
- שם הסביבה
- חבילת proxy ל-API
- קובץ מעקב של בקשות ה-API שמוצגות לגביהן שגיאות של פסק זמן בלקוח
- יומני גישה של NGINX (
/opt/apigee/var/log/edge-router/nginx/ORG~ENV.PORT#_access_log) - יומני מעבד בקשות (
/opt/apigee/var/log/edge-message-processor/logs/system.log)